离线强化学习总结!(原理、数据集、算法、复杂性分析、超参数调优等)
来源知乎,作者丨旺仔搬砖记
由于内容过长,本文仅展示部分内容,完整系列请查阅博客:https://www.zhihu.com/column/c_1487193754071617536
离线强化学习(Offline RL)作为深度强化学习的子领域,其不需要与模拟环境进行交互就可以直接从数据中学习一套策略来完成相关任务,被认为是强化学习落地的重要技术之一。本文详细的阐述了强化学习到离线强化学习的发展过程,并就一些经典的问题进行了解释和说明。
1.1 深度强化学习简介
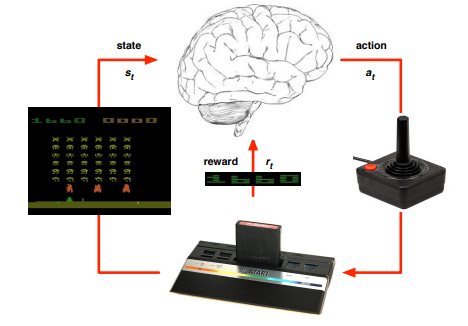
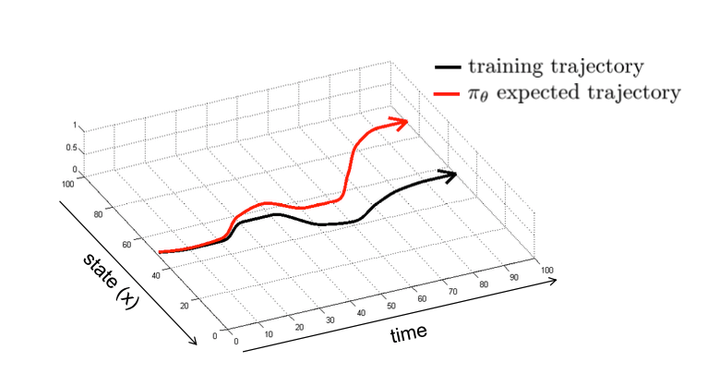
1.1.1 On-Policy和off-Policy区别
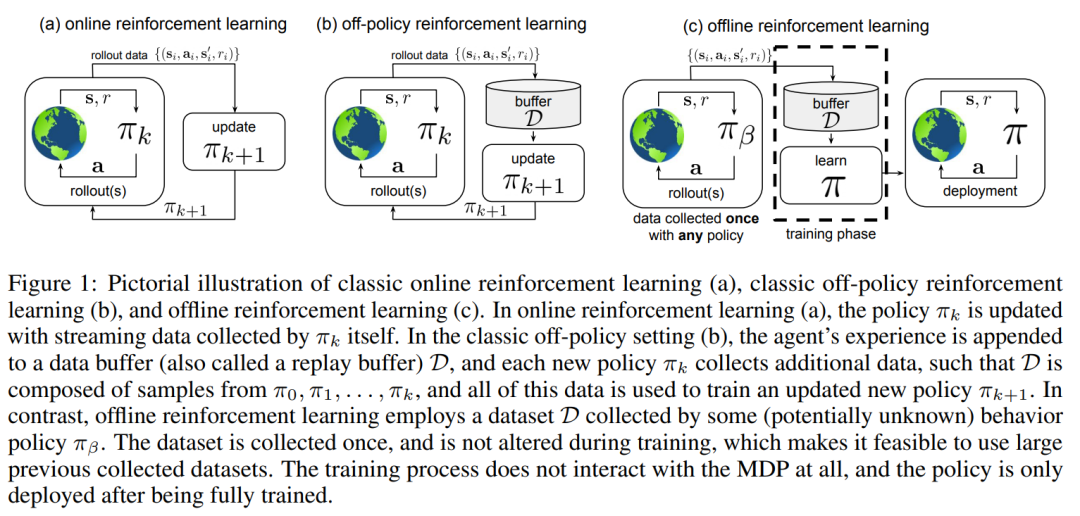
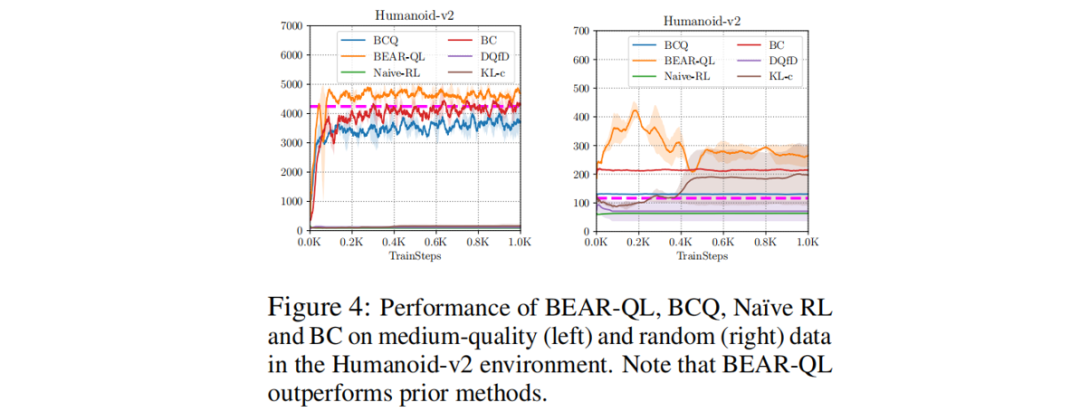
【补充】两者在学习方式上的区别:若agent与环境互动,则为On-policy(此时因为agent亲身参与,所以互动时的policy和目标的policy一致);若agent看别的agent与环境互动,自己不参与互动,则为Off-policy(此时因为互动的和目标优化的是两个agent,所以他们的policy不一致)。两者在采样数据利用上的区别:On-policy:采样所用的policy和目标policy一致,采样后进行学习,学习后目标policy更新,此时需要把采样的policy同步更新以保持和目标policy一致,这也就导致了需要重新采样。Off-policy:采样的policy和目标的policy不一样,所以你目标的policy随便更新,采样后的数据可以用很多次也可以参考。
原文:On-policy methods attempt to evaluate or improve the policy that is used to make decisions, whereas off-policy methods evaluate or improve a policy different from that used to generate the data.
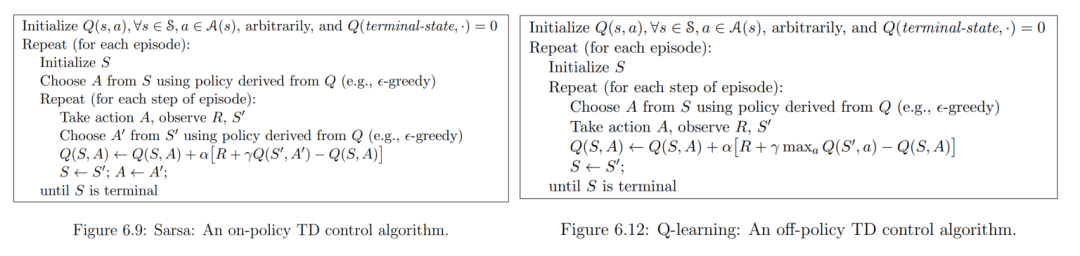
on-policy优点是直接了当,速度快,劣势是不一定找到最优策略。off-policy劣势是曲折,收敛慢,但优势是更为强大和通用。
如何从采样轨迹(trajectory)中高效学习 Off-policy采样效率高,收敛慢,仍然是最重要的解决问题方法
1.1.2 Online和Offline学习的本质
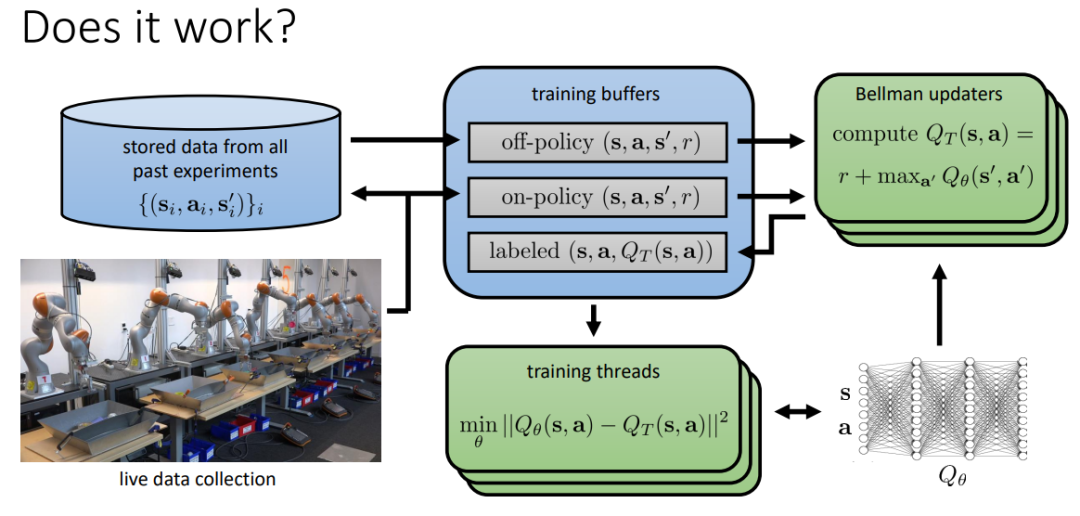
Online一方面是与环境有交互,通过采集数据学习、然后丢弃,而offline则是不用交互,直接通过采集到的轨迹数据学习,这也是off-policy到offline转换的重要原因。
1.2 落地应用的困难?
有模拟器,易产生数据,好用!
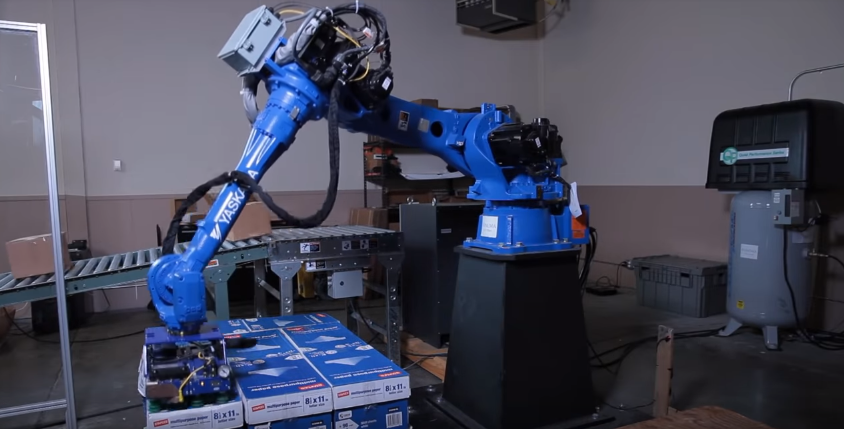
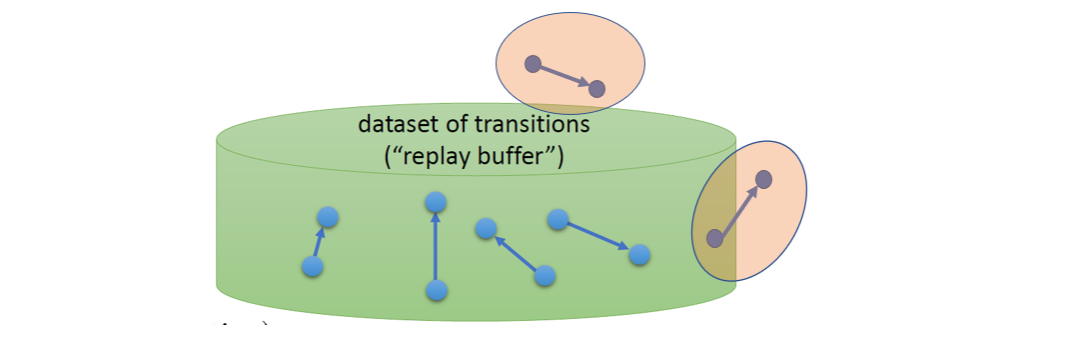
由于样本收集很困难,或者很危险。所以实时的和环境进行交互是不太可能的,那么可否有一种仅利用之前收集的数据来训练的方法去学习策略呢? 不管它是on-policy还是off_policy,我只要经验回放池中的交互历史数据,往大一点就是logg数据库中的数据(此处就不能探索exploration),去拟合函数是否可行? 仅利用轨迹数据学习的策略能否和Online算法的媲美?
2.离线强化学习
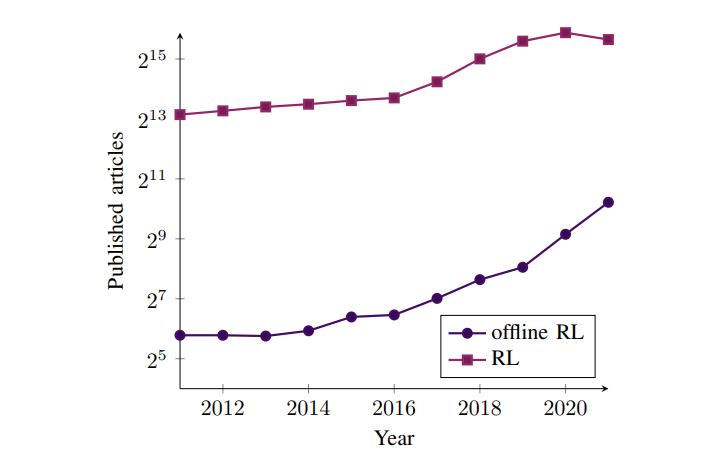
2.1 离线强化学习原理
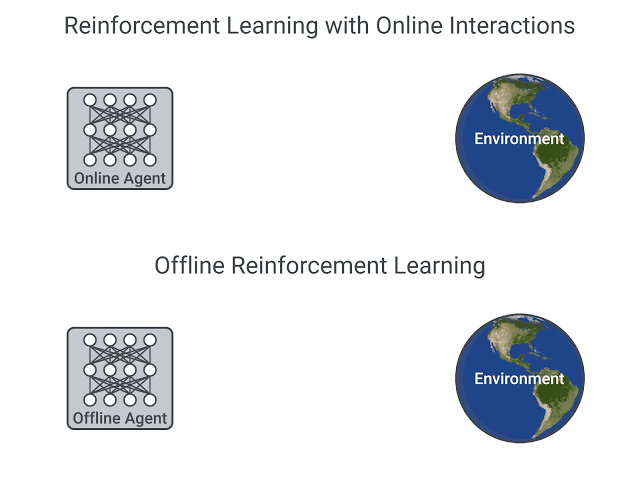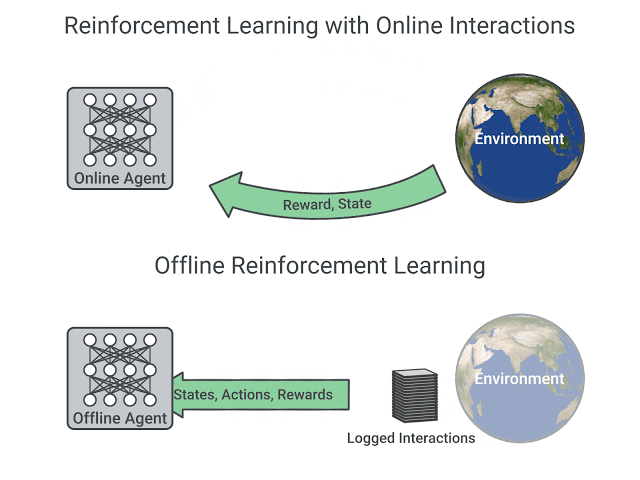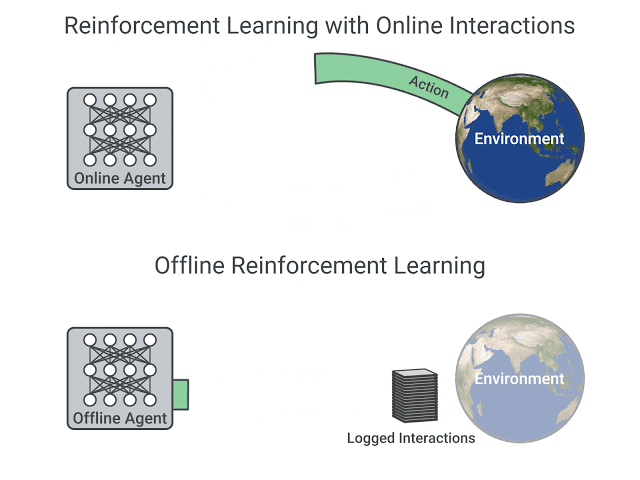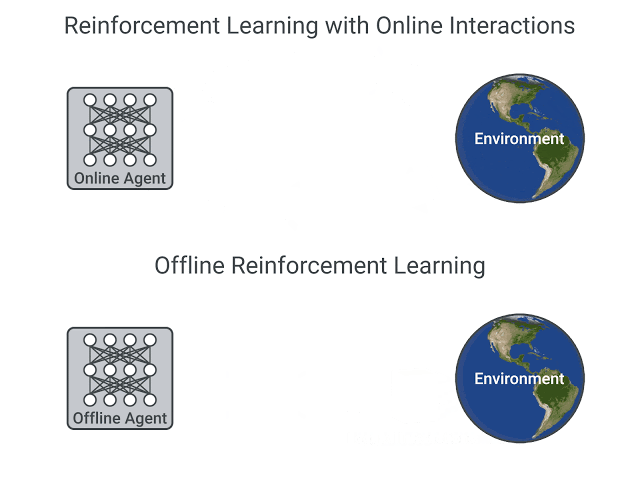
2.2 离线强化学习分类及区别
2.2.1 如何判断 Offline RL
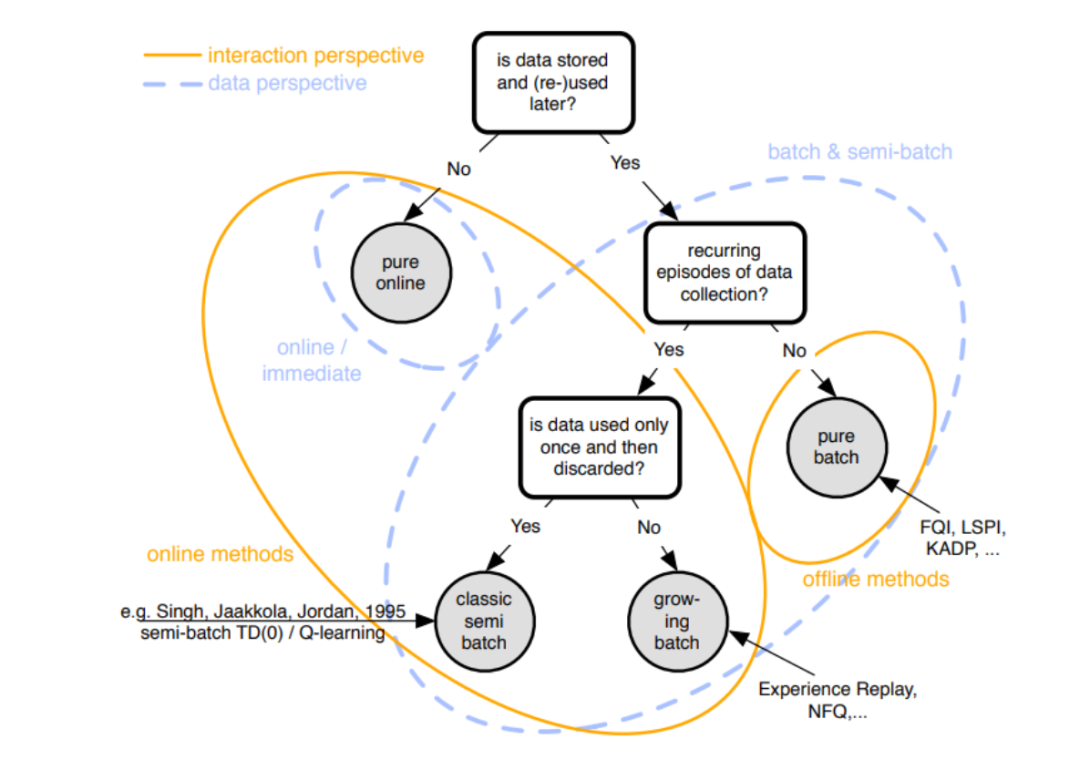
备注:离线强化学习去学习数据可以使专家数据、预训练(Pre-Train)模型产生的数据、随机(random)数据等。
2.2.2 offline RL的分类
2.2.3 Offline RL&模仿学习的区别
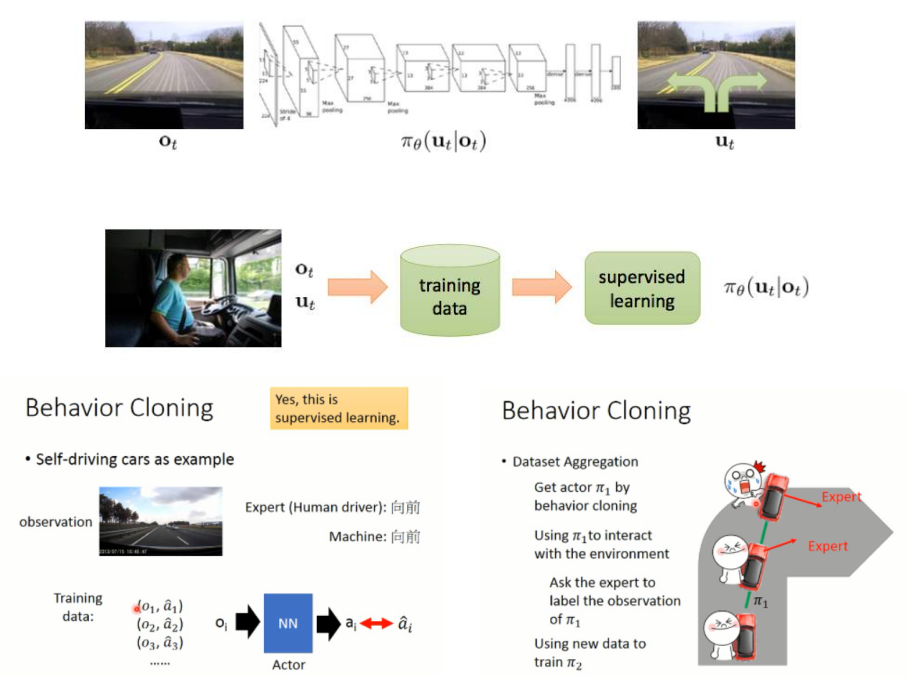
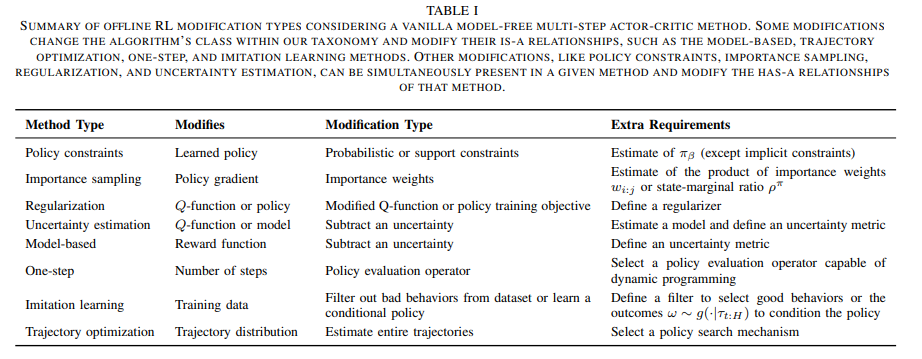
Offline RL 算法(到目前为止)建立在标准的off-policy深度强化学习算法之上,这些算法倾向于优化某种形式的贝尔曼方程或TD误差。 大多数 IL 问题假设有一个最优的,或者至少是一个高性能的提供数据的演示器,而Offline RL 可能必须处理高度次优(subopt)的数据。 大多数 IL 问题没有奖励函数。Offline RL 有奖励,而且可以事后处理和修改。 一些 IL 问题需要将数据标记为专家与非专家。Offline RL 不做这个假设(可以是专家、已训练好的模型产生的轨迹,随机数据)。
2.3 离线强化学习很难学习的原因
2.3.1 无法探索(Explore)
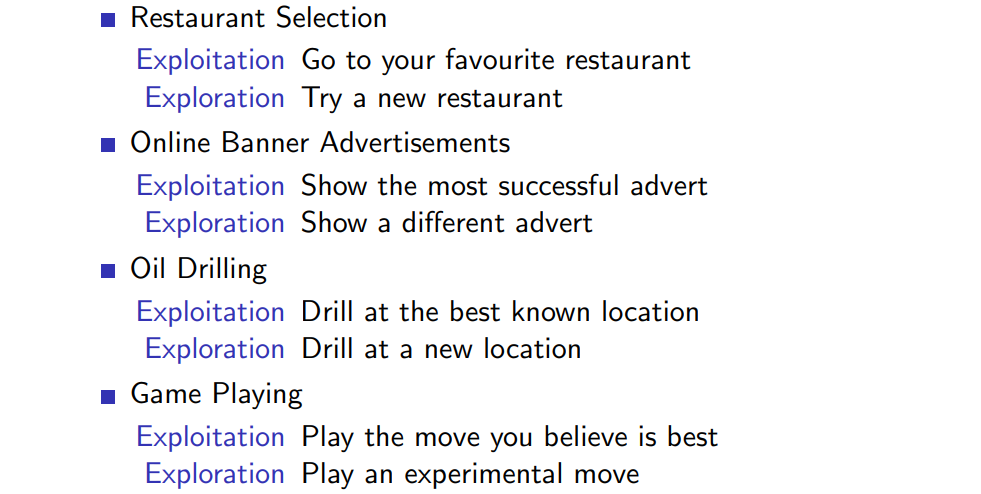
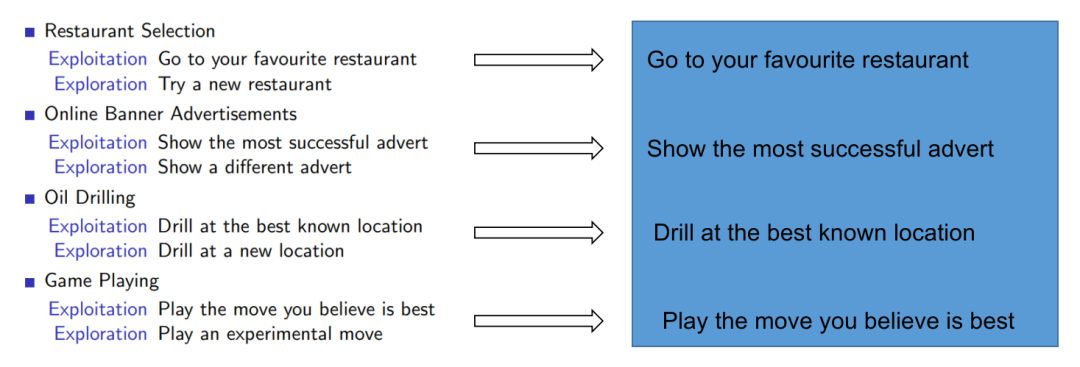
Exploration是为了收集更多信息(尝试一些不可能等),而Exploitation则根据当前信息做出最佳决策,正如Sliver总结的:
2.3.2 数据质量(拟合与过拟合)
如果轨迹(数据)全部是专家数据,Offline RL算法会学习到好策略吗? 如果轨迹全是预训练好的模型(比如训练好的PPO模型)产生的,Offline RL算法会学习到好策略吗? 如果轨迹全是没有任何经验,而是随机产生的,Offline RL算法会学习到好策略吗? 如果轨迹是上述三种的混合,具体的比例多少才能训练出通用、高效的offline RL算法?
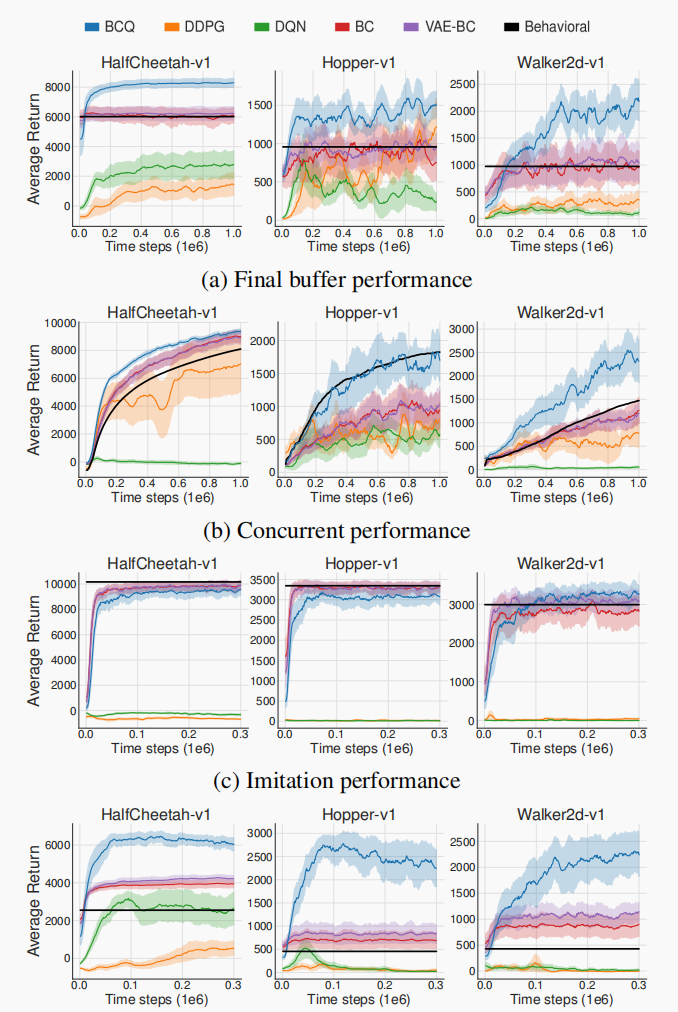
备注:Final buffer: train a DDPG agent for 1 million time steps, adding N (0, 0.5) Gaussian noise to actions for high exploration, and store all experienced transitions.Concurrent:train the off-policy and behavioral DDPG agents, for 1 million time steps. To ensure sufficient exploration, a standard N (0, 0.1) Gaussian noise is added to actions taken by the behavioral policy.
2.3.3 分布偏移(Distribution shift)
2.3.3.1 关于分布偏移
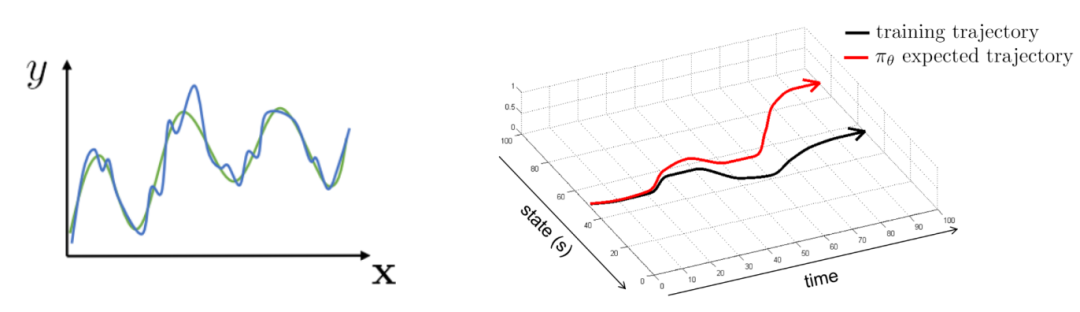 也就是让图中的左子图的平均损失函数最小化,那么这里就存在一个问题,给定一个最优的 , 那么 也是最优的吗?(注意这里:)
如果 , 则是最小的 如果 , 则不是,因为对于普通的
2.3.3.2 分布偏移对OfflineRL算法收敛的影响
2.4 Offline RL 发展时间线
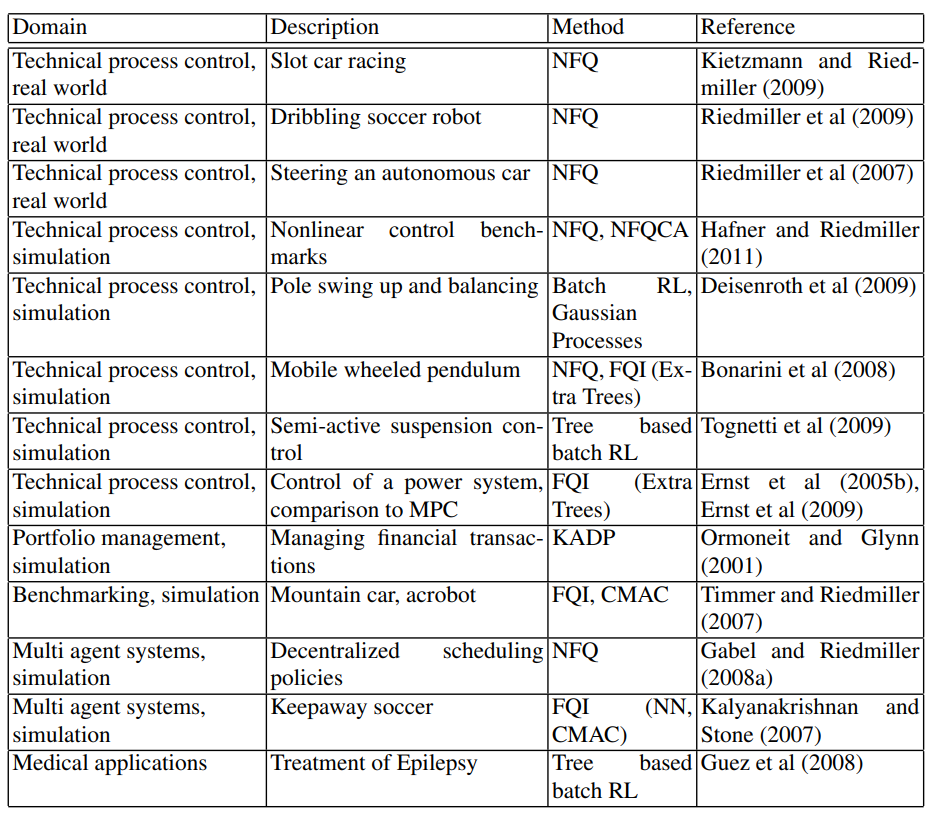
2.5为什么选择 D4RL?
通过人工演示或硬编码控制器生成的数据。 具有不同策略的异构混合的数据 数据观察智能体在同一环境中完成各种目标。
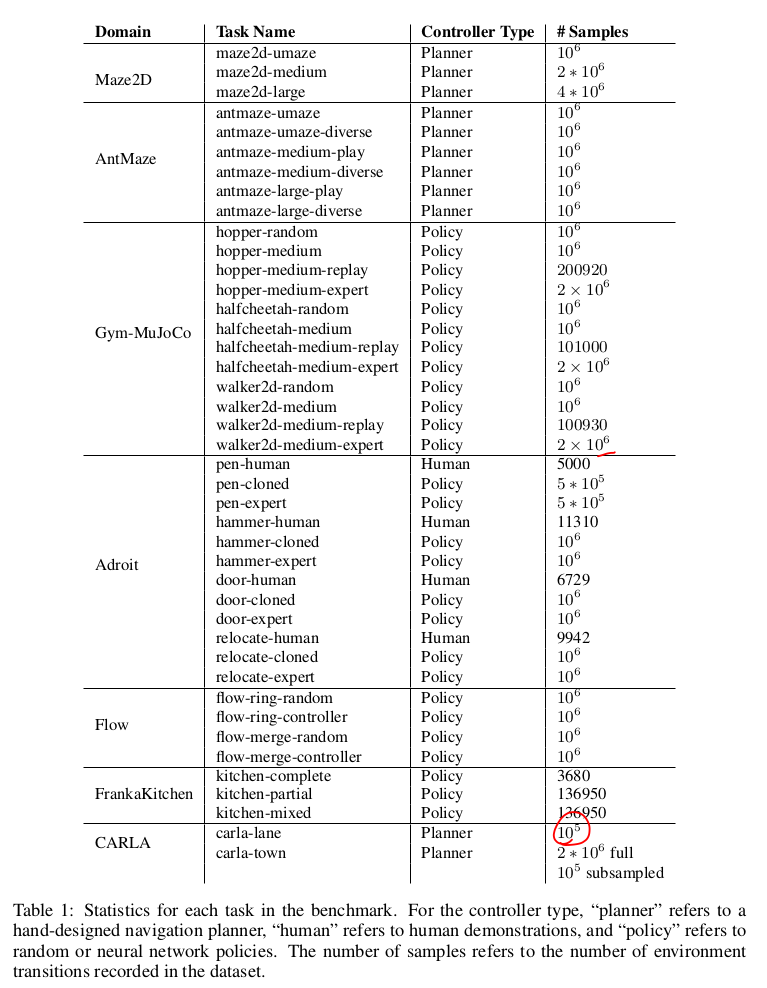
import d4rl # Import required to register environments
env = gym.make('maze2d-umaze-v1')
dataset = env.get_dataset()
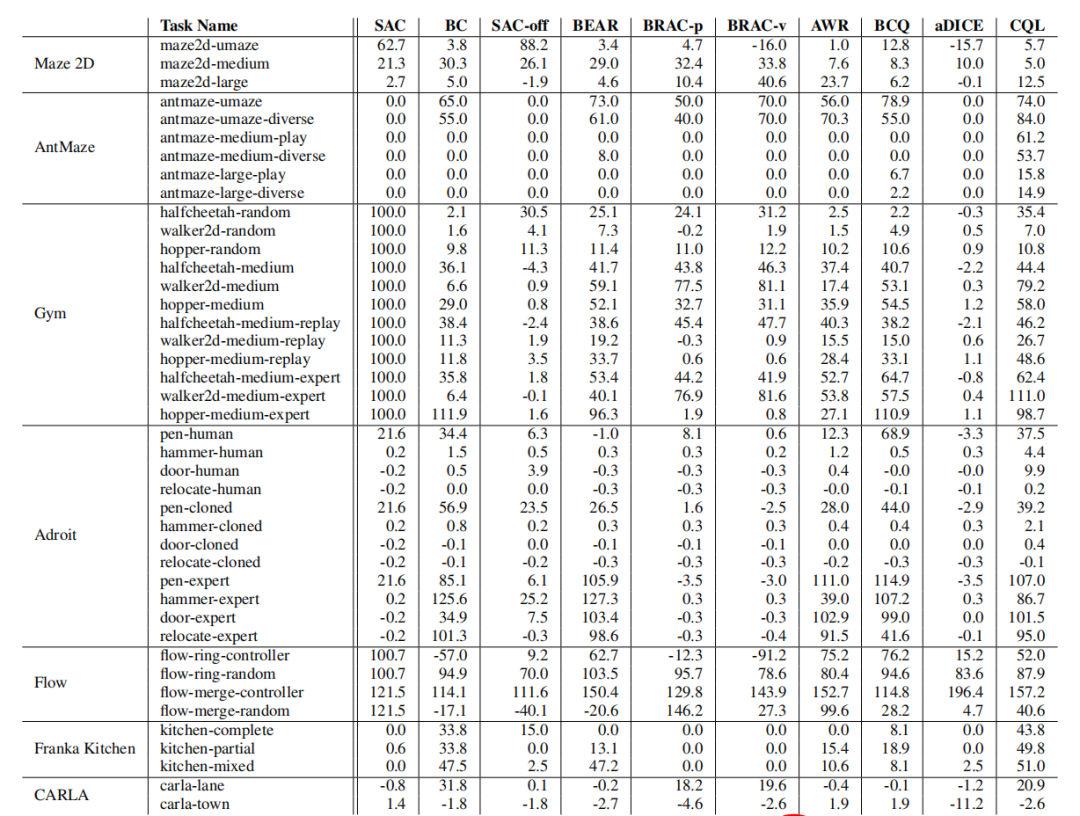
2.6 D4RL数据集制作影响因素
Narrow and biased data distributions Undirected and multitask data Sparse rewards Suboptimal data. Non-representable behavior policies, non-Markovian behavior policies, and partial observ-
ability.Realistic domains
2.1 官方安装指导(有坑)
git clone https://github.com/rail-berkeley/d4rl.git
cd d4rl
pip install -e .
pip install git+https://github.com/rail-berkeley/d4rl@master#egg=d4rl
from distutils.core import setup
from platform import platform

from setuptools import find_packages

setup(
    name='d4rl',
    version='1.1',
    install_requires=['gym',
                      'numpy',
                      'mujoco_py',
                      'pybullet',
                      'h5py',
                      'termcolor',  # adept_envs dependency
                      'click',  # adept_envs dependency
                      'dm_control' if 'macOS' in platform() else
                      'dm_control @ git+git://github.com/deepmind/dm_control@master#egg=dm_control',
                      'mjrl @ git+git://github.com/aravindr93/mjrl@master#egg=mjrl'],
    packages=find_packages(),
    package_data={'d4rl': ['locomotion/assets/*',
                           'hand_manipulation_suite/assets/*',
                           'hand_manipulation_suite/Adroit/*',
                           'hand_manipulation_suite/Adroit/gallery/*',
                           'hand_manipulation_suite/Adroit/resources/*',
                           'hand_manipulation_suite/Adroit/resources/meshes/*',
                           'hand_manipulation_suite/Adroit/resources/textures/*',
                           ]},
    include_package_data=True,
)
2.2 有效安装过程(避坑)
第一步:安装mujoco210(针对没有安装mujoco)
# 下载地址 https://github.com/deepmind/mujoco/releases/tag/2.1.0
cd ~/Downloads/
wget https://github.com/deepmind/mujoco/releases/download/2.1.0/mujoco210-linux-x86_64.tar.gz
mv mujoco210-linux-x86_64.tar.gz mujoco210
tar -zxvf mujoco210-linux-x86_64.tar.gz
mkdir ~/mujoco
cp -r mujoco210 ~/mujoco
# 添加环境变量
sudo gedit ~/.bashrc
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:$HOME/.mujoco/mujoco210/bin
export MUJOCO_KEY_PATH=~/.mujoco${MUJOCO_KEY_PATH}
source ~/.bashrc

# 测试
cd ~/.mujoco/mujoco210/bin/
./simulate ../model/humanoid.xml
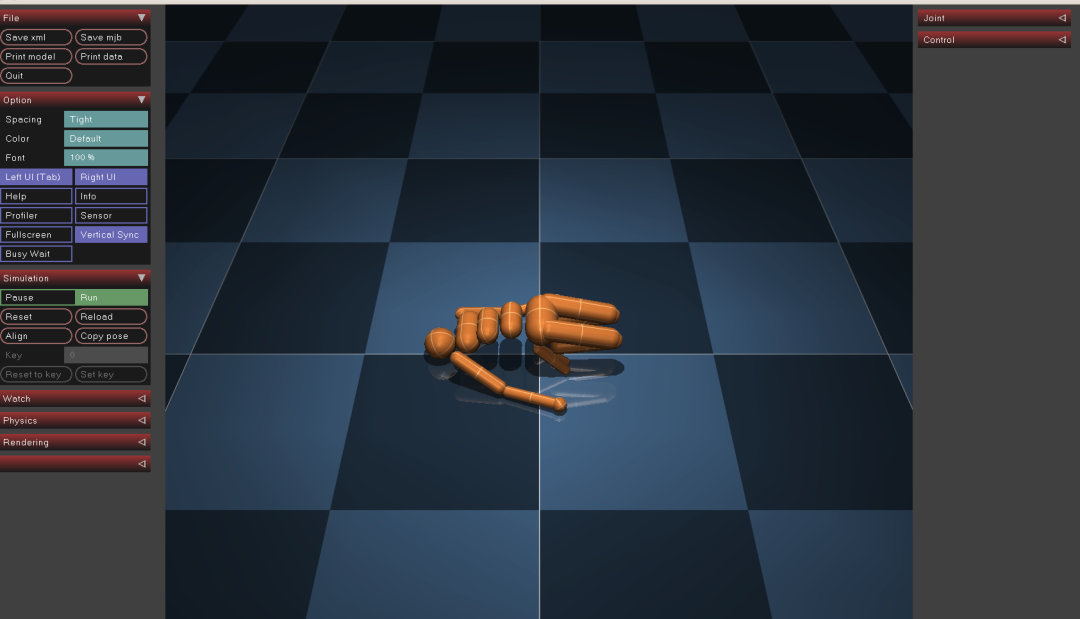
坑1:can't find /.mujoco/lib/libmujoco.so.2.1.1(可能安装mujoco200的伙伴会遇到)
export MJLIB_PATH=~/.mujoco/lib/libmujoco.so.2.1.1
source ~/.bashrc
第二步:安装mujoco_py
# 本步跳过conda环境创建,直接进入虚拟环境(conda create -n d4rl python=3.7)
conda create -n d4rl python=3.7
conda activate d4rl
pip install mujoco_py

python
Python 3.7.11 (default, Jul 27 2021, 14:32:16)
[GCC 7.5.0] :: Anaconda, Inc. on linux
Type "help", "copyright", "credits" or "license" for more information.
>>> import mujoco_py
>>>
# 备:没有报错表示安装成功
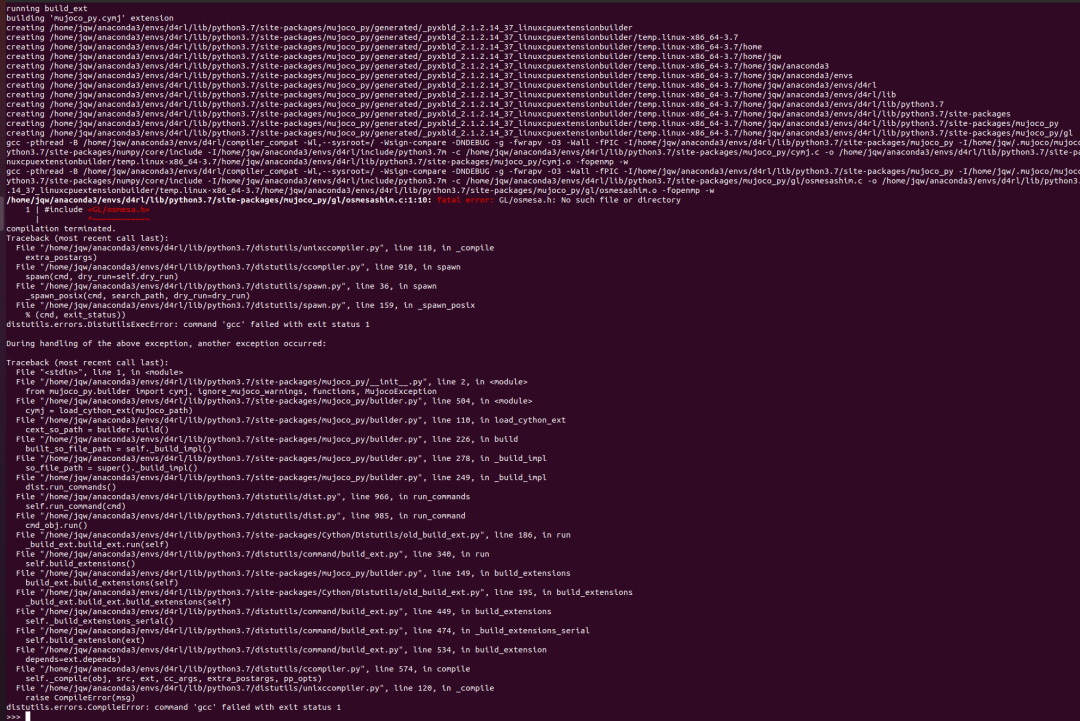
坑2:如果是fatal error: GL/osmesa.h: No such file or directory,那就安装libosmesa6-dev
Python 3.7.11 (default, Jul 27 2021, 14:32:16)
[GCC 7.5.0] :: Anaconda, Inc. on linux
Type "help", "copyright", "credits" or "license" for more information.
>>> import mujoco_py
running build_ext
building 'mujoco_py.cymj' extension
gcc -pthread -B /home/jqw/anaconda3/envs/d4rl/compiler_compat -Wl,--sysroot=/ -Wsign-compare -DNDEBUG -g -fwrapv -O3 -Wall -fPIC -I/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py -I/home/jqw/.mujoco/mujoco210/include -I/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/numpy/core/include -I/home/jqw/anaconda3/envs/d4rl/include/python3.7m -c /home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/cymj.c -o /home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/generated/_pyxbld_2.1.2.14_37_linuxcpuextensionbuilder/temp.linux-x86_64-3.7/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/cymj.o -fopenmp -w
gcc -pthread -B /home/jqw/anaconda3/envs/d4rl/compiler_compat -Wl,--sysroot=/ -Wsign-compare -DNDEBUG -g -fwrapv -O3 -Wall -fPIC -I/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py -I/home/jqw/.mujoco/mujoco210/include -I/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/numpy/core/include -I/home/jqw/anaconda3/envs/d4rl/include/python3.7m -c /home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/gl/osmesashim.c -o /home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/generated/_pyxbld_2.1.2.14_37_linuxcpuextensionbuilder/temp.linux-x86_64-3.7/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/gl/osmesashim.o -fopenmp -w
/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/gl/osmesashim.c:1:10: fatal error: GL/osmesa.h: No such file or directory
1 | #include
| ^~~~~~~~~~~~~
compilation terminated.
Traceback (most recent call last):
File "" , line 1, in
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/__init__.py", line 2, in
from mujoco_py.builder import cymj, ignore_mujoco_warnings, functions, MujocoException
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/builder.py", line 504, in
cymj = load_cython_ext(mujoco_path)
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/builder.py", line 110, in load_cython_ext
cext_so_path = builder.build()
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/builder.py", line 226, in build
built_so_file_path = self._build_impl()
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/builder.py", line 278, in _build_impl
so_file_path = super()._build_impl()
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/builder.py", line 249, in _build_impl
dist.run_commands()
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/distutils/dist.py", line 966, in run_commands
self.run_command(cmd)
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/distutils/dist.py", line 985, in run_command
cmd_obj.run()
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/Cython/Distutils/old_build_ext.py", line 186, in run
_build_ext.build_ext.run(self)
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/distutils/command/build_ext.py", line 340, in run
self.build_extensions()
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/mujoco_py/builder.py", line 149, in build_extensions
build_ext.build_extensions(self)
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/site-packages/Cython/Distutils/old_build_ext.py", line 195, in build_extensions
_build_ext.build_ext.build_extensions(self)
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/distutils/command/build_ext.py", line 449, in build_extensions
self._build_extensions_serial()
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/distutils/command/build_ext.py", line 474, in _build_extensions_serial
self.build_extension(ext)
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/distutils/command/build_ext.py", line 534, in build_extension
depends=ext.depends)
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/distutils/ccompiler.py", line 574, in compile
self._compile(obj, src, ext, cc_args, extra_postargs, pp_opts)
File "/home/jqw/anaconda3/envs/d4rl/lib/python3.7/distutils/unixccompiler.py", line 120, in _compile
raise CompileError(msg)
distutils.errors.CompileError: command 'gcc' failed with exit status 1
sudo apt install libosmesa6-dev
# 补充命令:sudo apt-get install libgl1-mesa-glx libosmesa6
坑3:如果是fatal error: GL/glew.h: No such file or directory,那么就安装Glew库
sudo apt-get install libglew-dev glew-utils
sudo apt-get -y install patchelf
第三步:安装dm_control
pip install dm_control
第四步:安装d4rl
git clone https://github.com/rail-berkeley/d4rl.git
install_requires=['gym',
                      'numpy',
                      # 'mujoco_py',
                      'pybullet',
                      'h5py',
                      'termcolor',  # adept_envs dependency
                      'click',  # adept_envs dependency
                      # 'dm_control' if 'macOS' in platform() else
                      # 'dm_control @ git+git://github.com/deepmind/dm_control@master#egg=dm_control',
                      'mjrl @ git+git://github.com/aravindr93/mjrl@master#egg=mjrl'],
# installing
pip install -e .

# 测试,创建test_d4rlpy.py并添加如下内容 vim test_d4rl.py

import gym
import d4rl # Import required to register environments

# Create the environment
env = gym.make('maze2d-umaze-v1')

# d4rl abides by the OpenAI gym interface
env.reset()
env.step(env.action_space.sample())

# Each task is associated with a dataset
# dataset contains observations, actions, rewards, terminals, and infos
dataset = env.get_dataset()
print(dataset['observations']) # An N x dim_observation Numpy array of observations

# Alternatively, use d4rl.qlearning_dataset which
# also adds next_observations.
dataset = d4rl.qlearning_dataset(env)


python test_d4rlpy.py
坑5:如果遇到:下面问题,那就单独安装mjrl
ERROR: Could not find a version that satisfies the requirement mjrl (unavailable) (from d4rl) (from versions: none)
ERROR: No matching distribution found for mjrl (unavailable)
pip install git+https://github.com/rail-berkeley/d4rl@master#egg=d4rl
# cuda、anaconda等环境变量可以设置在本部分以前
# 环境变量次序也很重要

# mujoco(这里我安装了两部分)
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:$HOME/.mujoco/mujoco210/bin
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:$HOME/.mujoco/mujoco211/bin

export MUJOCO_KEY_PATH=~/.mujoco${MUJOCO_KEY_PATH}
export MJLIB_PATH=~/.mujoco/lib/libmujoco.so.2.1.1

# nvidia
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/usr/lib/nvidia

export LD_PRELOAD=~/anaconda3/envs/d3rlpy/lib/python3.7/site-packages/d3rlpy/dataset.cpython-37m-x86_64-linux-gnu.so
# export LD_PRELOAD=/usr/lib/x86_64-linux-gnu/libGLEW.so:/usr/lib/nvidia-465/libGL.so

export LD_PRELOAD=/usr/lib/x86_64-linux-gnu/libGLEW.so
坑6:有的伙伴可能会用pycharm去运行mujoco会出现一个问题就是:有nvidia的环境变量没有mujoco的,有mujoco的没有nvidia的
Exception:
Missing path to your environment variable.
Current values LD_LIBRARY_PATH=
Please add following line to .bashrc:
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/home/jqw/.mujoco/mujoco210/bin

# 或者这样的
Exception:
Missing path to your environment variable.
Current values LD_LIBRARY_PATH=LD_LIBRARY_PATH:/usr/lib/nvidia
Please add following line to .bashrc:
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/home/jqw/.mujoco/mujoco210/bin

PYTHONUNBUFFERED=1;LD_LIBRARY_PATH=LD_LIBRARY_PATH:/usr/lib/nvidia:$LD_LIBRARY_PATH:/home/jqw/.mujoco/mujoco210/bin
TD3+BC算法详解
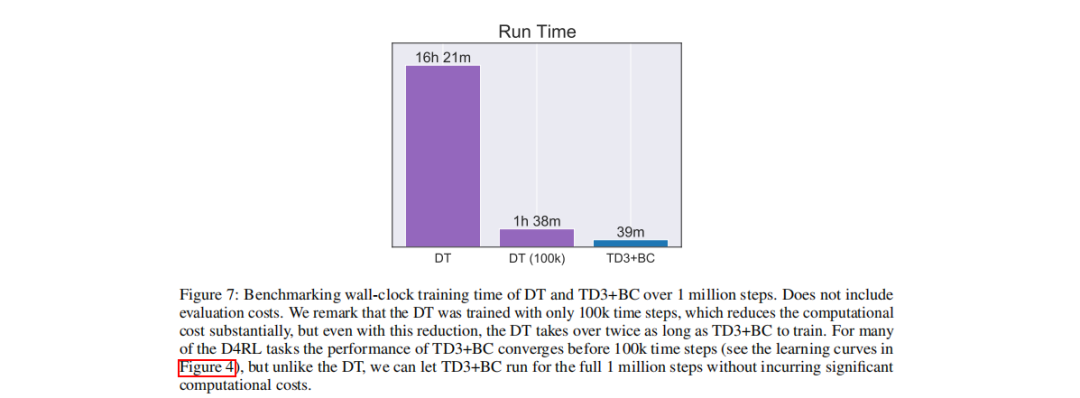
摘要:相比于几篇博客讲过的BCQ(通过扰动网络生成动作,不断将学习策略和行为策略拉进)、BEAR(通过支撑集匹配避免分布匹配的问题)、BRAC(通过VP和PR两个方法正则化)以及REM(通过随机集成混合方法对多个值函数求取凸优化最优的鲁棒性)方法。本文作者提出的TD3+BC方法,结构简单,仅在值函数上添加一个行为克隆(BC)的正则项,并对state进行normalizing,简单的对TD3修改了几行代码就可以与前几种方法相媲美,结果表明:TD3+BC效果好,训练时间也比其他少很多。
1. Offline RL的一些挑战。
实现和Tune的复杂性(Implementation and Tuning Complexities), 在强化学习中,算法的实现、论文的复现都是一个非常难的问题,很多算法并没法去复现,即使相同的seed有时候未必也能达到效果。同样在Offline中仍然存在,此外在Offline中还要解决分布偏移、OODd等之外的一些问题。 **额外算力需求(Extra Computation Requirement)**,由于过于复杂的数学优化、过多的超参数等算法的执行带来了很长的训练时间,导致不得不增加计算资源来学习算法使得其收敛。 **训练策略的不稳定性(Instability of Trained Policies)**,强化学习领域的不稳定性众所周知,所以Offline RL如何才能与Supervised leanring一样很稳定是一个重要的研究问题。 **Offline RL改进问题(algorithmic/Coding/Optimization)**,包括了代码层次的优化改进和理论结构方面的改进等。
2. TD3+BC原理
2.1 TD3+BC相比于其他的优势
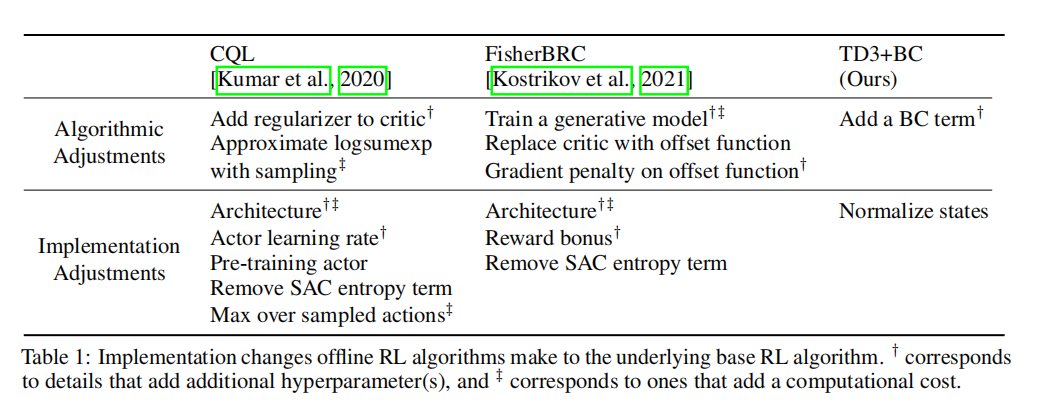
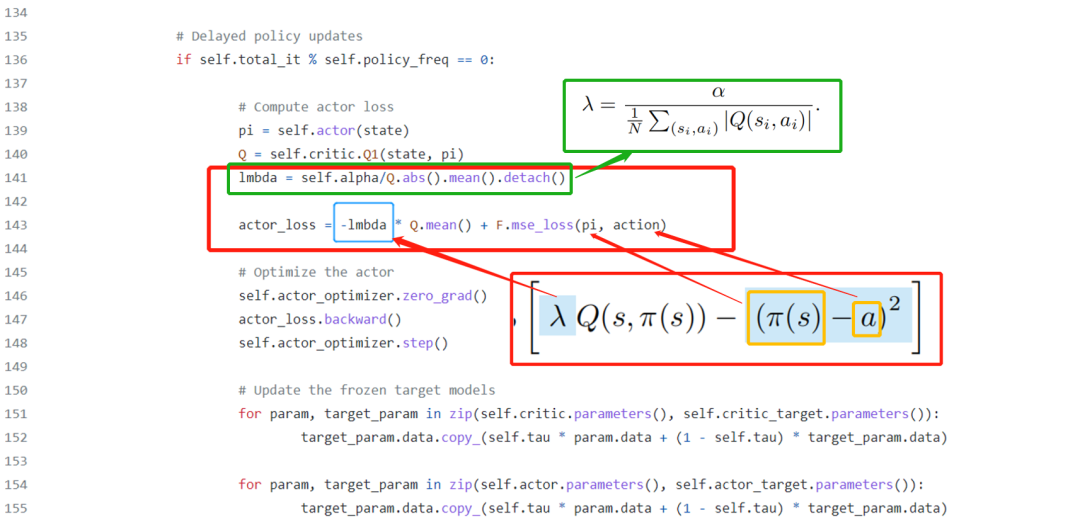
2.2 理论部分
个人看法: 有点像BCQ中的让学习策略和行为策略之间的距离减少那种意思,只不过添加到正则项里面.
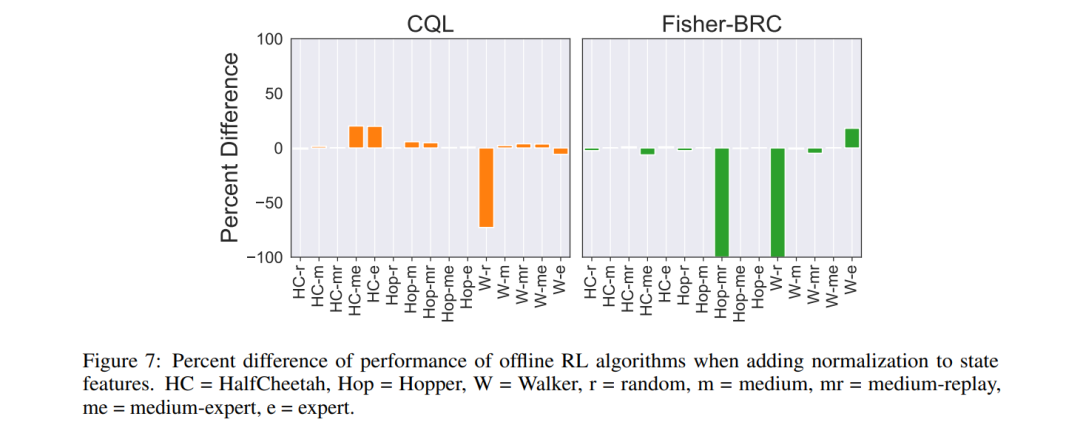
实验效果(关于纵坐标Percent difference后文有说明,本部分只看效果)
2.3 经典的Rebuttal场面
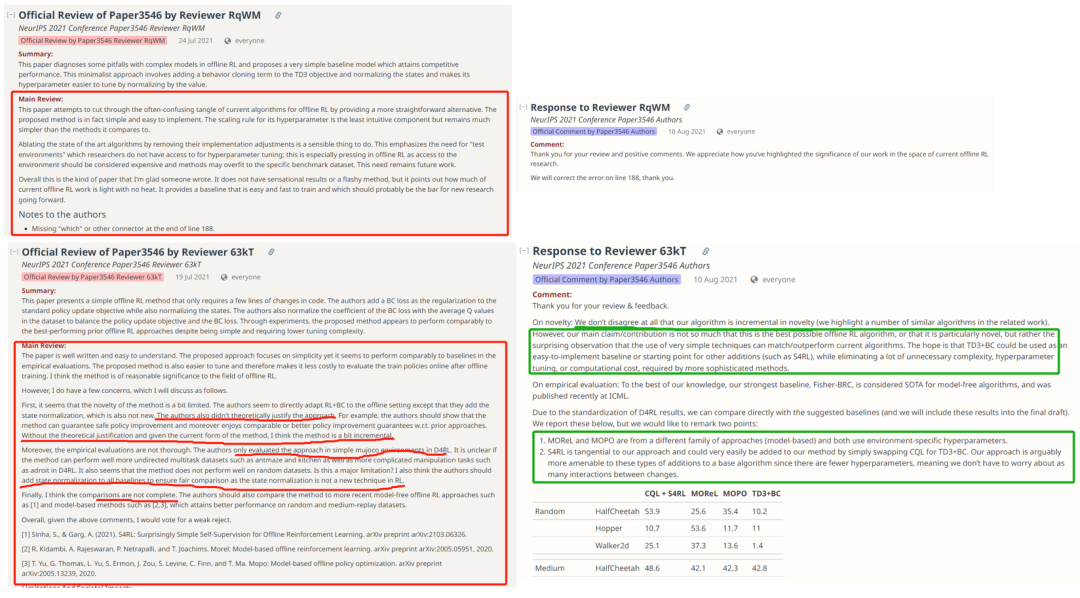
审稿人: (1)首先,该方法的新颖性似乎有点有限。作者似乎直接使 RL+BC 适应离线设置,只是他们添加了状态归一化,这也不是新的。作者也没有从理论上证明这种方法的合理性。例如,作者应该证明该方法可以保证安全的策略改进,并且享有可比或更好的策略改进保证 w.r.t.先前的方法。如果没有理论依据,并且考虑到该方法的当前形式,我认为该方法有点增量。 (2)此外,实证评估并不彻底。作者仅在 D4RL 中的简单 mujoco 环境中评估了该方法。目前尚不清楚该方法是否可以很好地执行更多无向多任务数据集,例如蚂蚁迷宫和厨房,以及更复杂的操作任务,例如 D4RL 中的 adroit。似乎该方法在随机数据集上表现不佳。这是一个主要限制吗?我还认为作者应该将状态归一化添加到所有基线以确保公平比较,因为状态归一化不是 RL 中的新技术。 (3)最后,我认为比较不完整。作者还应该将该方法与最近的无模型离线 RL 方法(如 [1])和基于模型的方法(如 [2,3])进行比较,后者在随机和中等重放数据集上获得了更好的性能。总的来说,鉴于上述评论,我会投票支持弱拒绝。
作者回复: (1)关于新颖性:我们完全不同意我们的算法在新颖性方面是递增的(我们在相关工作中强调了许多类似的算法)。然而,我们的主要主张/贡献与其说这是最好的离线 RL 算法,或者说它特别新颖,不如说是令人惊讶的观察,即使用非常简单的技术可以匹配/优于当前算法。希望 TD3+BC 可以用作易于实现的基线或其他添加(例如 S4RL)的起点,同时消除更复杂方法所需的许多不必要的复杂性、超参数调整或计算成本. (2)关于经验评估:据我们所知,我们最强的基线 Fisher-BRC 被认为是无模型算法的 SOTA,最近在 ICML 上发表。 (3)由于 D4RL 结果的标准化,我们可以直接与建议的基线进行比较(我们会将这些结果包含在最终草案中)。我们在下面报告这些,但我们想说明两点: (4)MOReL 和 MOPO 来自不同的方法系列(基于模型),并且都使用特定于环境的超参数。S4RL 与我们的方法相切,只需将 CQL 替换为 TD3+BC,就可以很容易地将其添加到我们的方法中。我们的方法可以说更适合基础算法的这些类型的添加,因为超参数更少,这意味着我们不必担心变化之间的交互作用。最终,我们没有发现添加状态归一化可以为基线提供相同水平的好处,这可能是因为这些方法需要超参数调整来补偿额外的修改。
3. 实验及过程分析
3.1 实验超参数
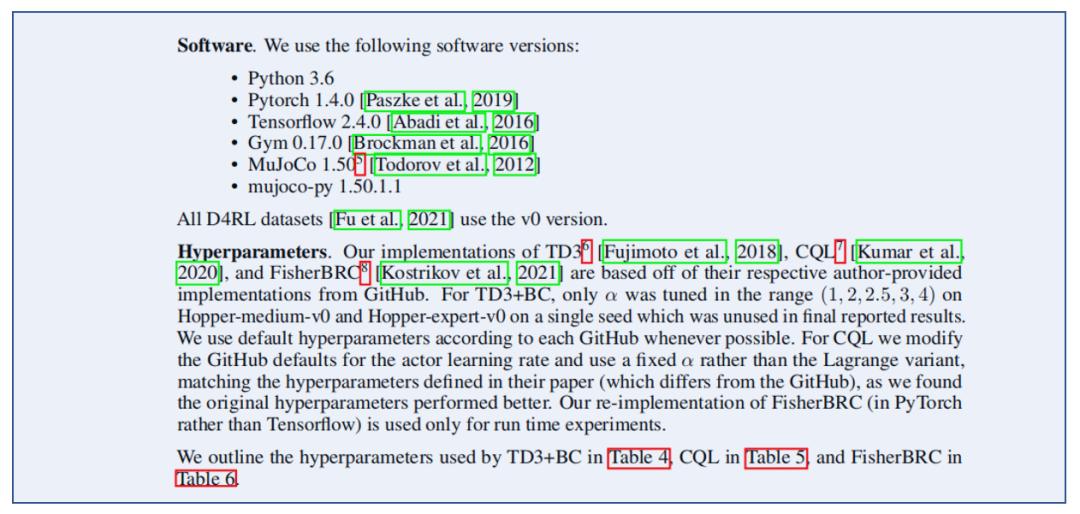
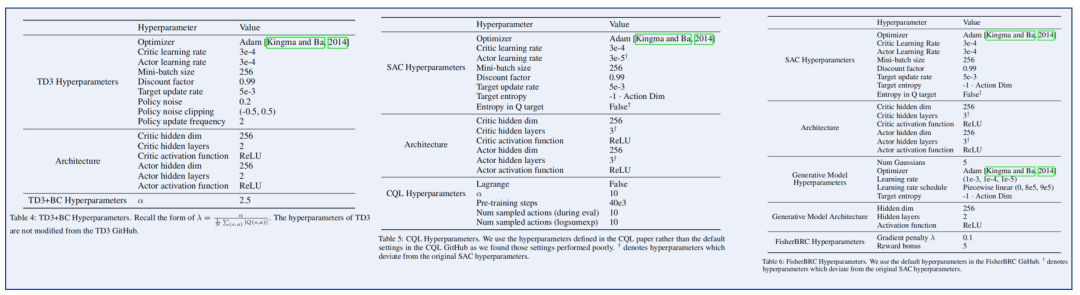
3.2 衡量指标:百分比差异(Percent Difference)
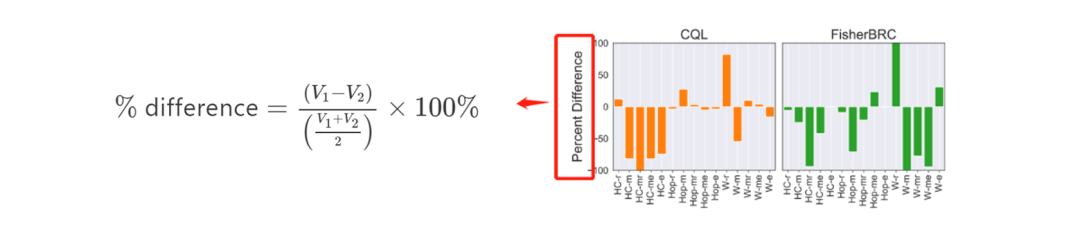
3.3 实验验证与结果简要分析
本实验参数
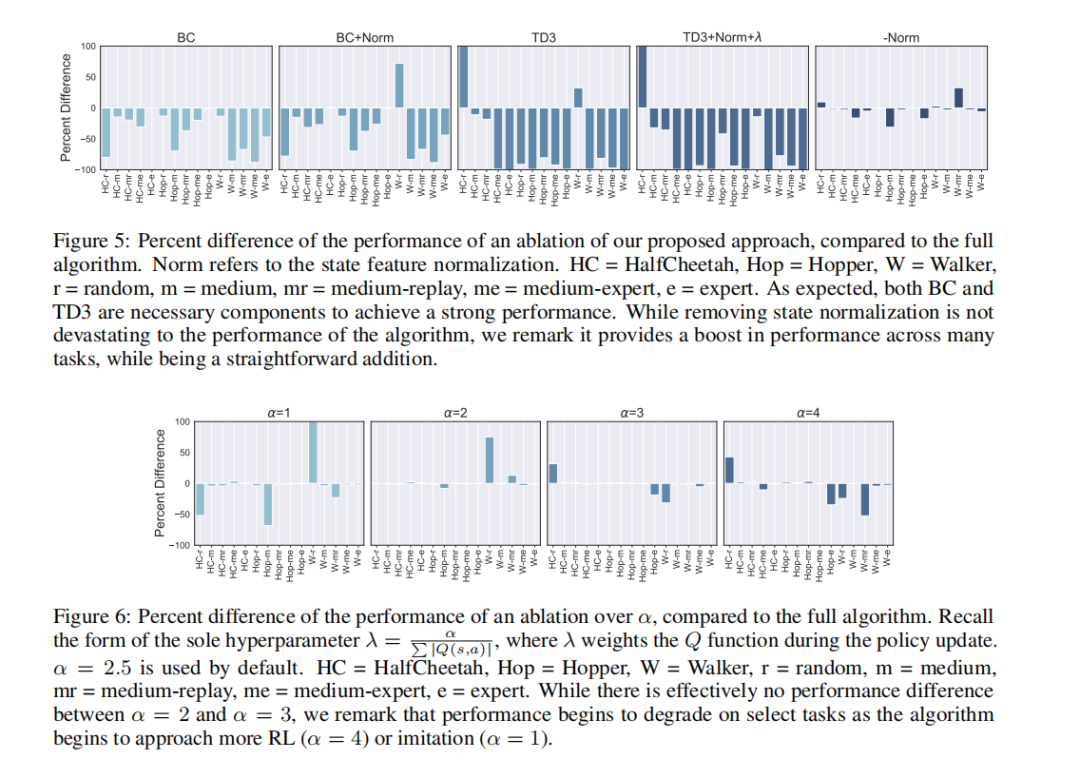
HC = HalfCheetah, Hop = Hopper, W = Walker, r = random, m = medium, mr = medium-replay, me = medium-expert, e = expert. While online algorithms (TD3) typically have small episode variances per trained policy (as they should at convergence),
3.3.1 D4RL验证讨论
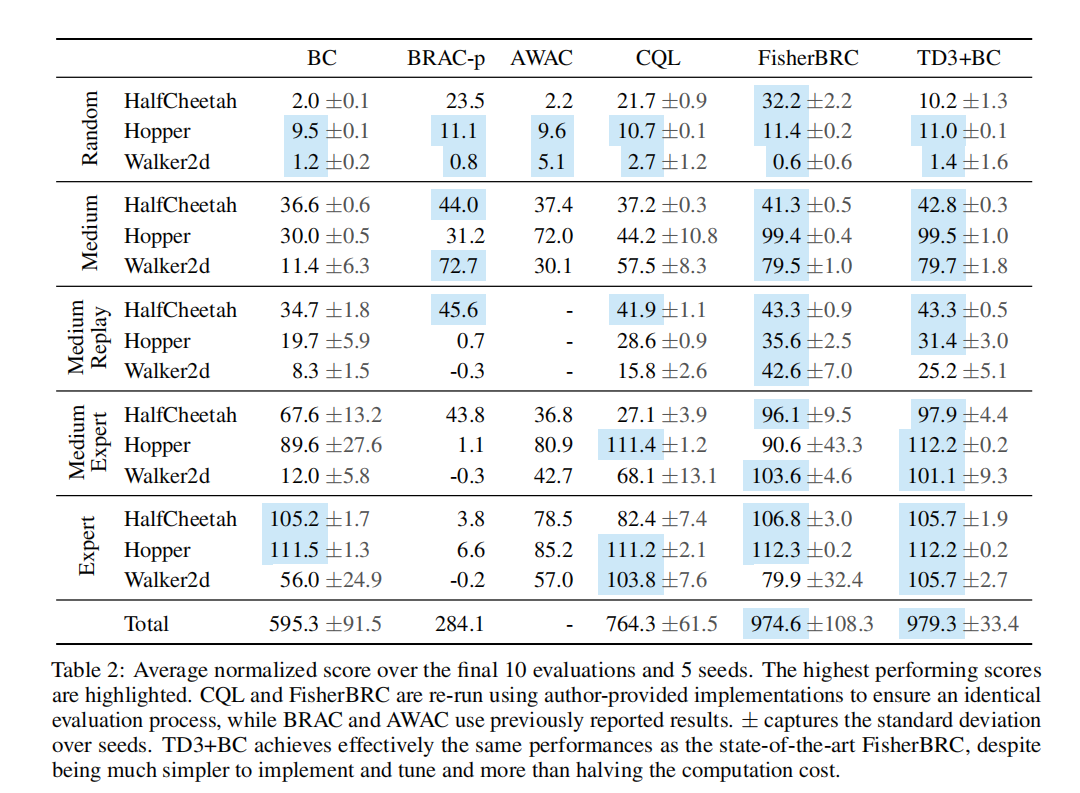
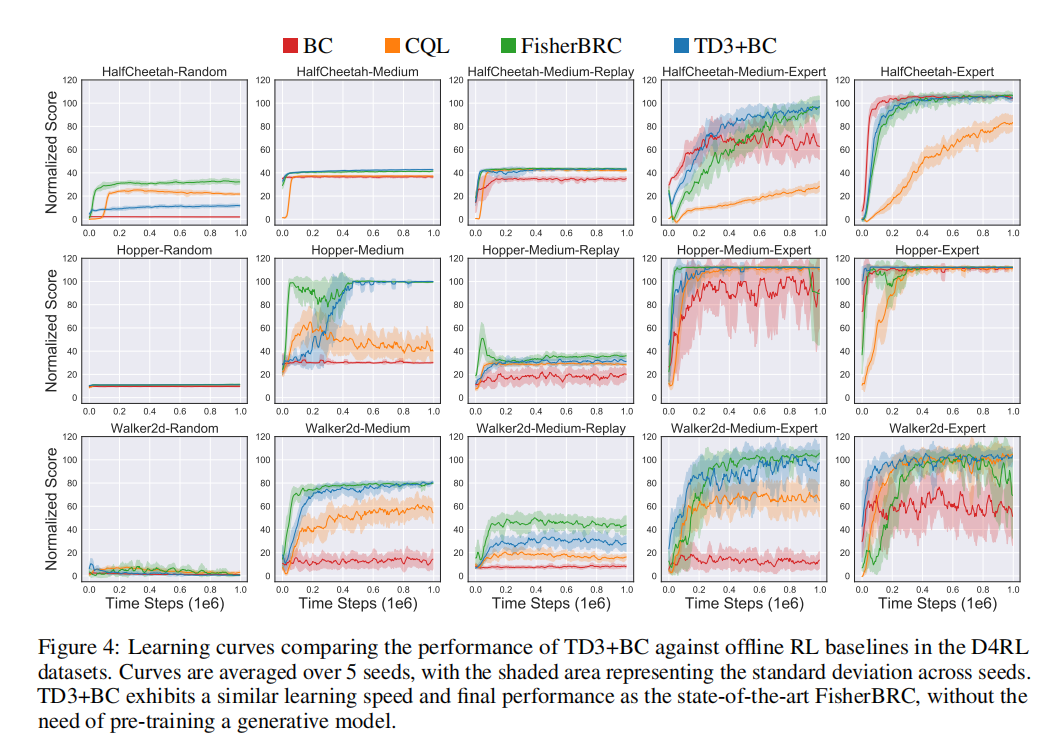
3.3.2 运行训练时间讨论
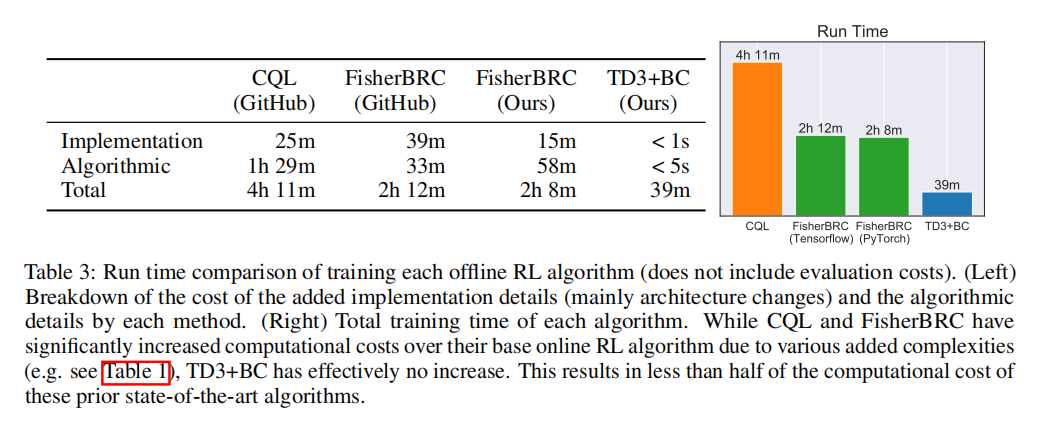
3.3.3 消融(ablation)实验(如何确定 ?)
2. Offline RL误差的来源
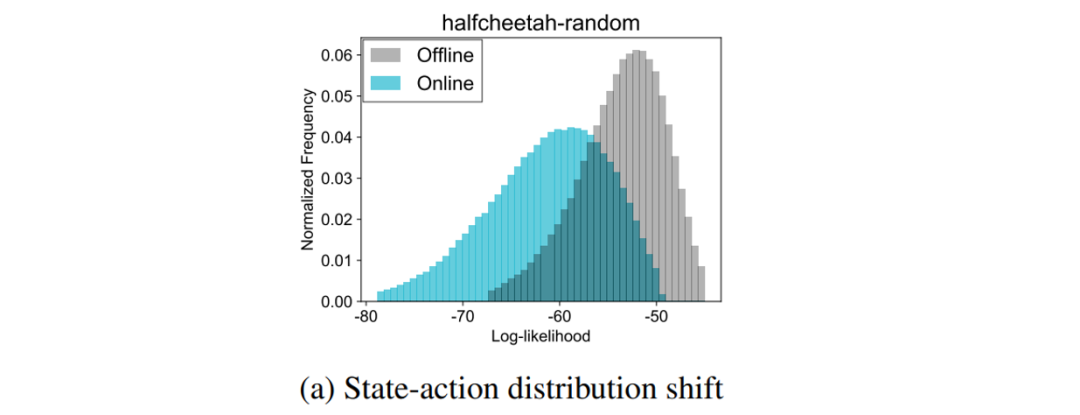
2.1 分布偏移(distribution shift)
2.2 OOD(out-of-distribution) action问题
 那么训练和优化过程如下:
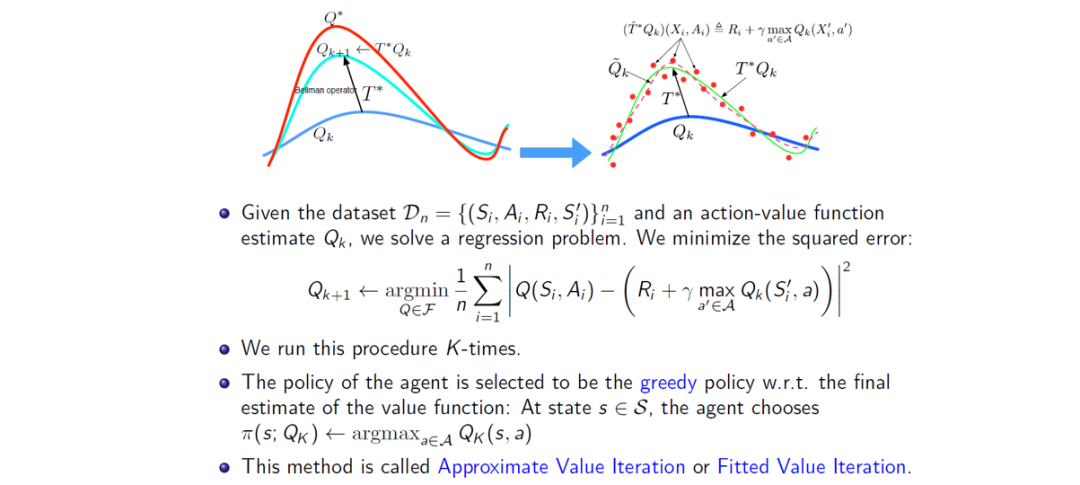
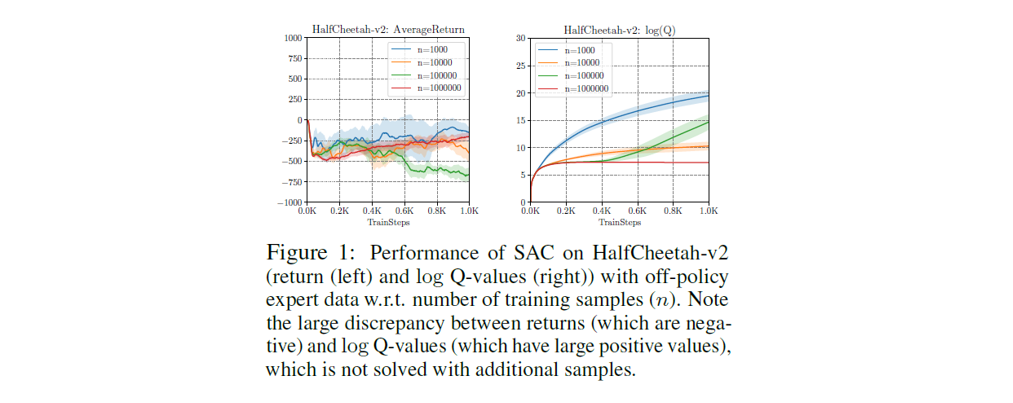
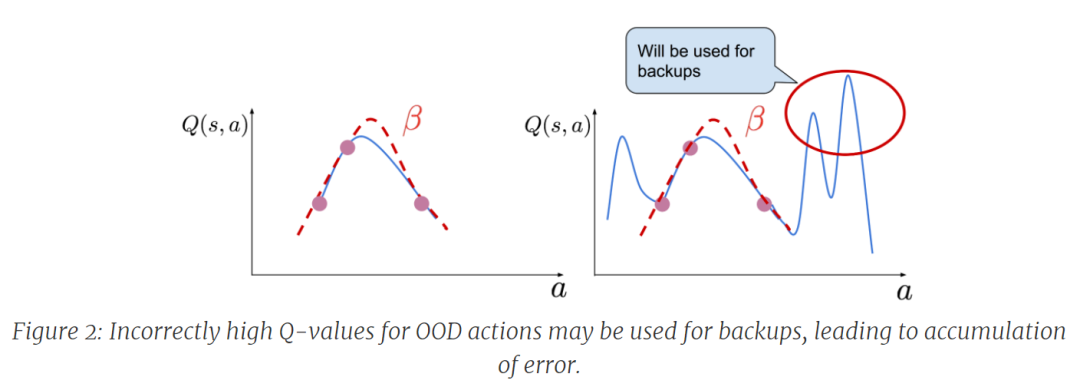
2.3 贝尔曼误差(Bellman error)
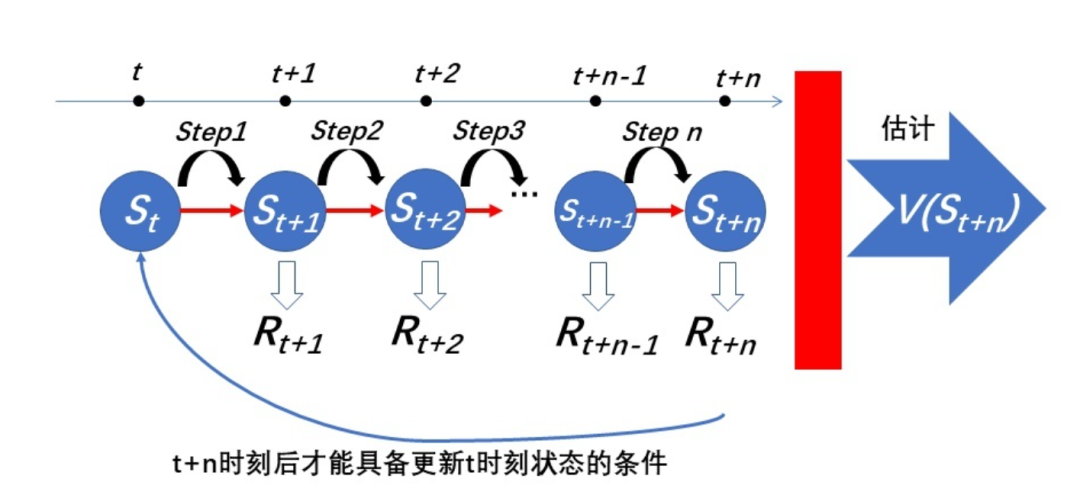
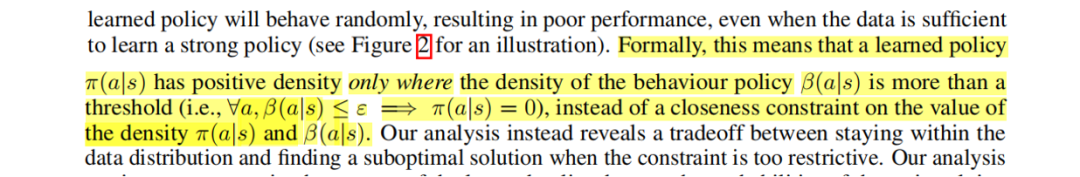
所谓的Support-set, 其实就是"学习策略 只有在行为策略 的密度大于阈值 ,而不是对密度 和 的值的接近约束。"
原话:
3. 从一个例子原因分析开始
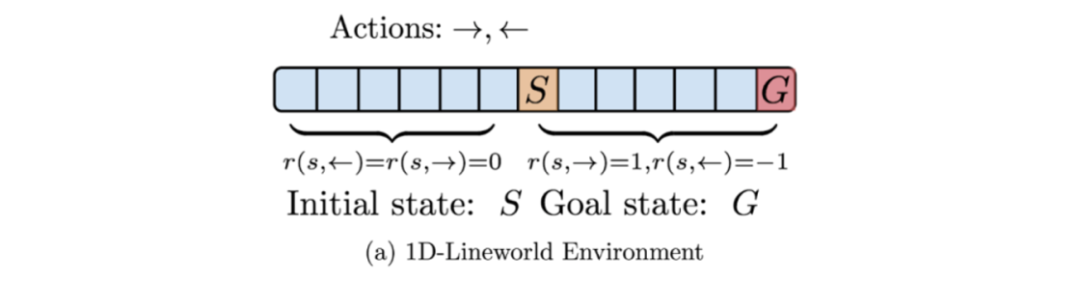
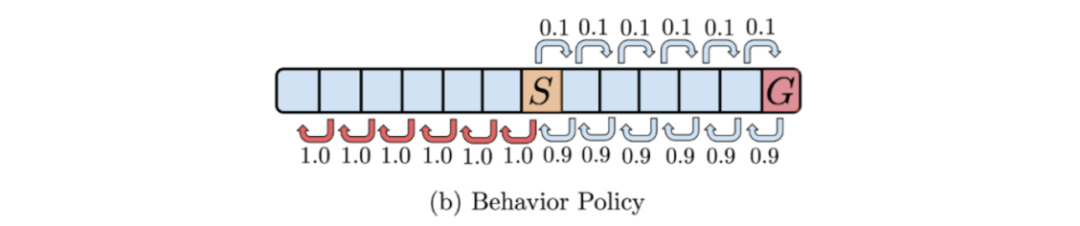 那么,行为策略在 和 之间的状态下执行次优动作,可能性为 0.9,但是动作 和 的状态都在分布内(in-distribution)。
个人理解原因
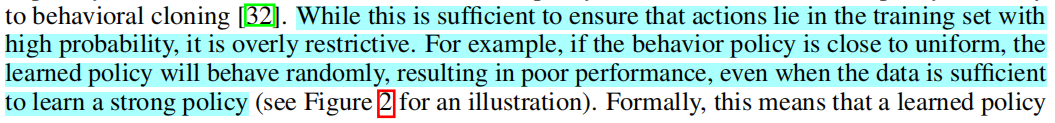
3.1 Distribution-matching
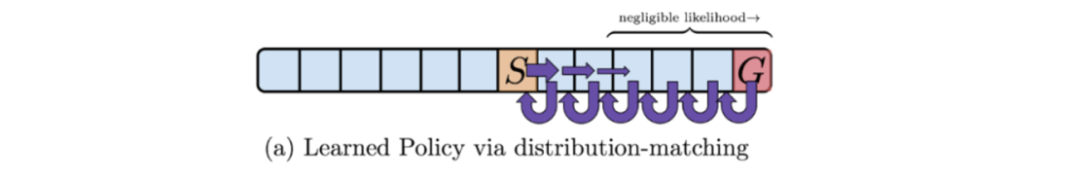 如上图,分布匹配约束(distribution matching constraint)的学习策略可以是任意次优的,事实上,通过推出该策略达到目标 G 的概率非常小,并且随着环境的建立而趋于 0 较大。
3.2 Support-constraint
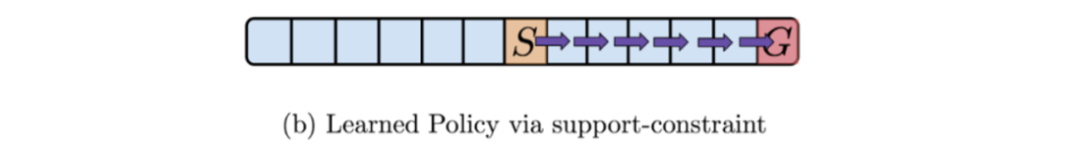 然而,在support-constraint中,作者表明支持约束可以恢复概率为 1 的最优策略(其实原因很简单,就是阈值 的原因, 只要动作在训练行为策略分布的支持集内就可以)。
如果惩罚被严格执行,那么智能体将被迫在 和 之间的状态中主要执行错误的动作 ,导致次优行为。 如果惩罚没有严格执行,为了实现比行为策略更好的策略,智能体将使用 OOD之外的action 在 左侧的状态执行backups,这些backups 最终会影响 状态S下的Q值。这种现象将导致不正确的 Q 函数,从而导致错误的策略——可能是从 S 开始向左移动而不是向 G 移动的策略,因为 OOD 动作backups与高估偏差相结合Q-learning 可能会使状态 S 的动作 看起来更可取。如下图所示,一些状态需要强惩罚/约束(以防止 OOD backups),而其他状态需要弱惩罚/约束(以实现最优性)才能使分布匹配起作用,但是,这无法通过传统的分布匹配来实现方法。
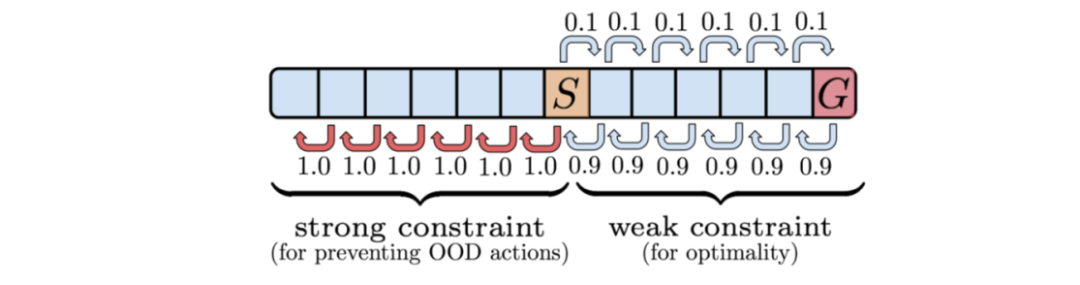
通过上述分析,我们得出一个结论:我们希望的不是学习策略和行为策略越像越好,而是学习策略能够在行为策略的支撑集的范围内去进行优化, 如果学习策略和行为策略无限接近那不就是Behavior clone了,但offline无法无限的去逼近online,所以问题仍然存在。
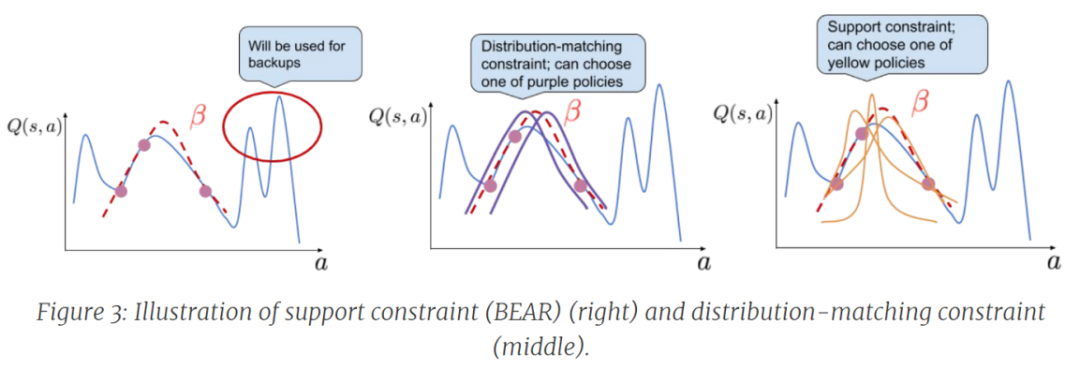
4. 理论设计及分析(核心:建议阅读)
4.1 Support-set Matching(支撑集匹配方法)
4.1.1 支撑集匹配原理
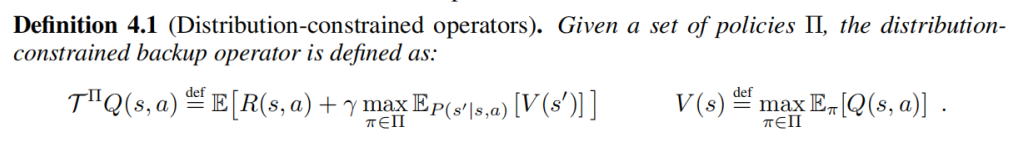
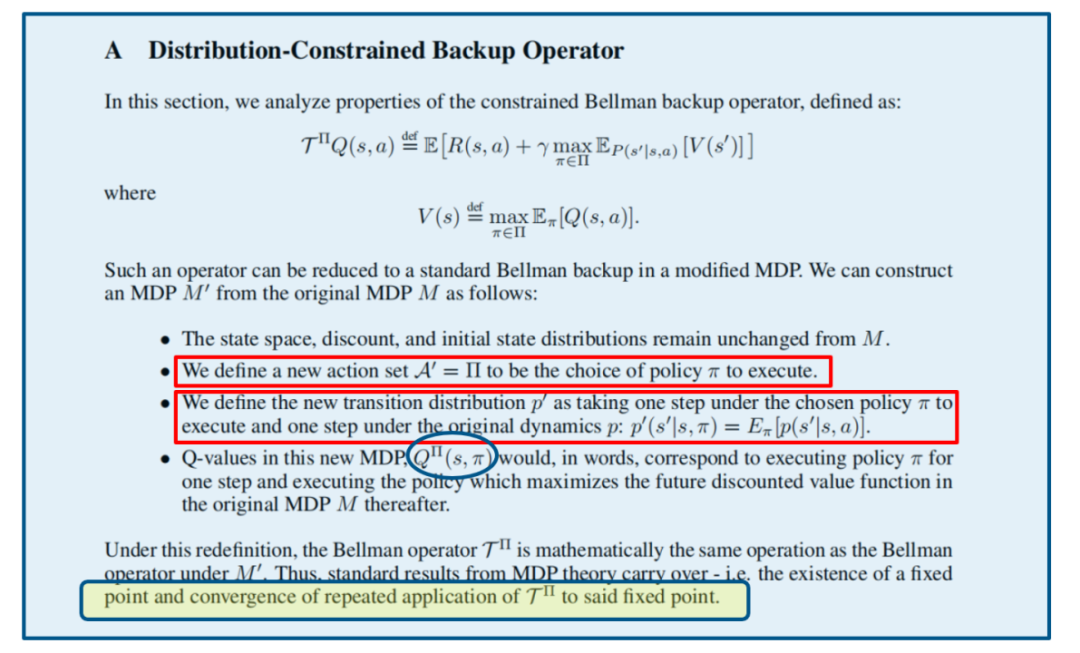
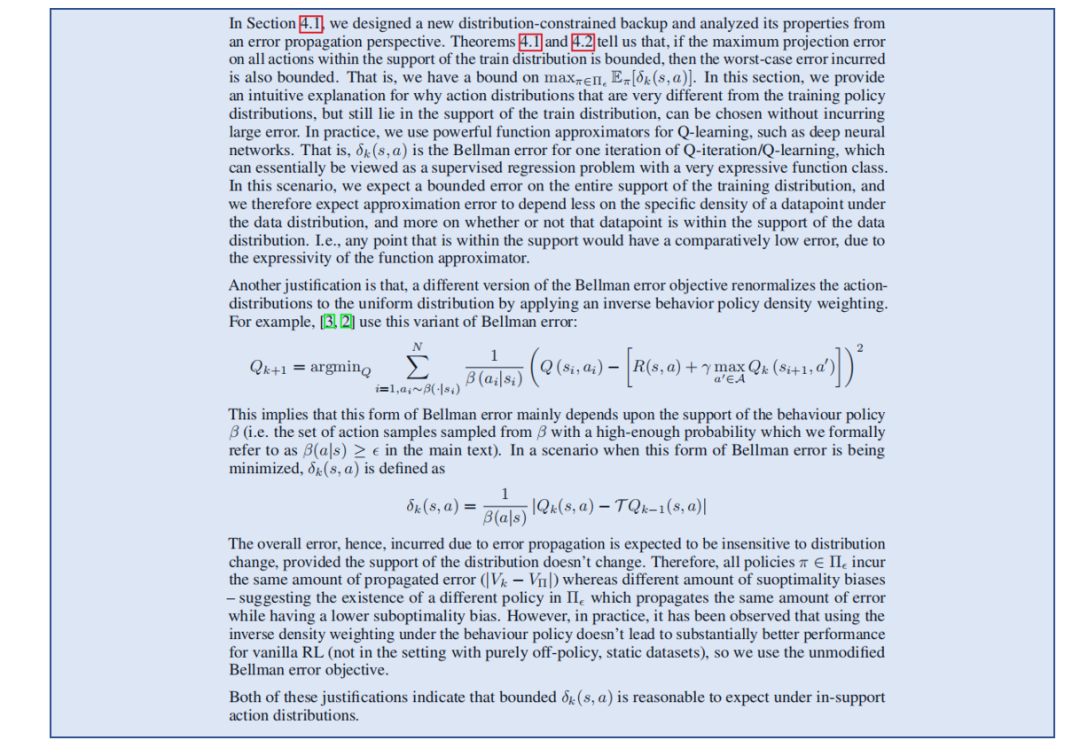
定义了一个策略集 ,且动作空间 ,而不是定义策略 根据原始的MDP问题重新定义了一个新的MDP" 问题,原理和bellman operator一样,同样利用了不动点去证明收敛性。
次优偏置(suboptimality bias), 也就是最优的学习策略如果在行为策略支撑集之外的话,仍然能够找到次优策略。 次优常数(suboptimality constant),分布偏移、OOD之外的次优问题,次优常数相当于做了一个限定(which measures how far is from ), 【 越小,policy set 距离optimal policy 的距离越小。】
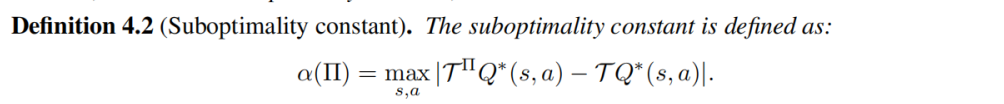
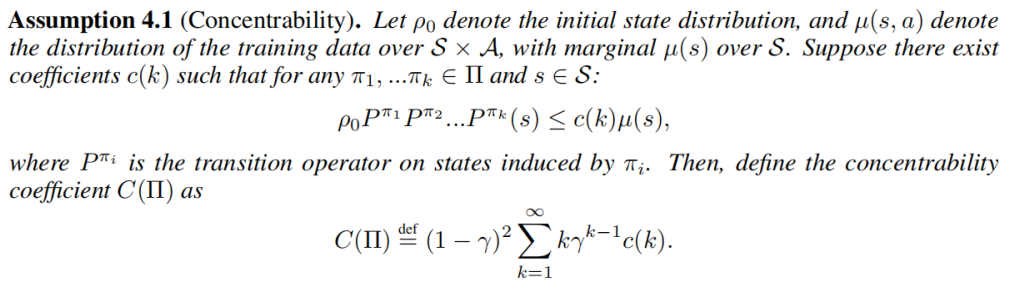
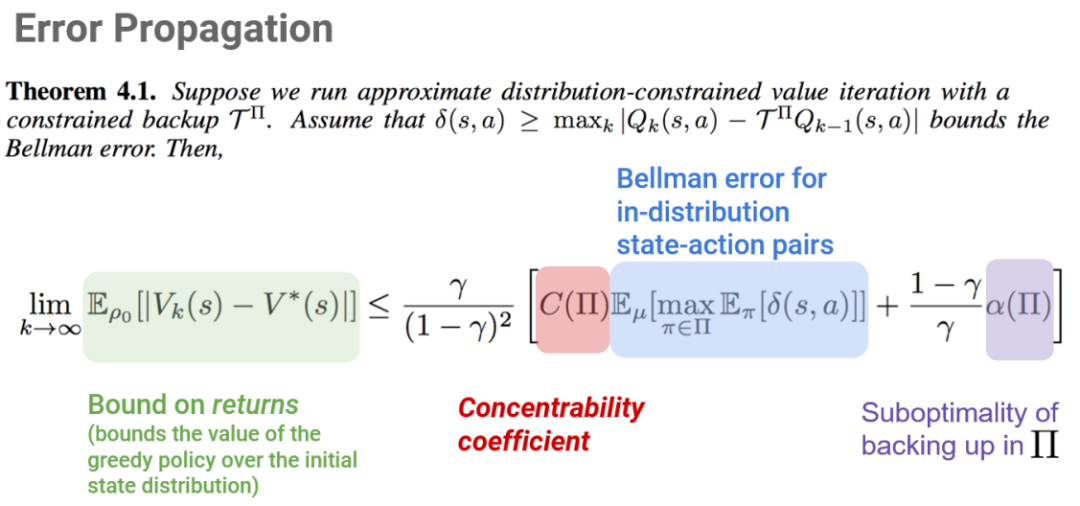
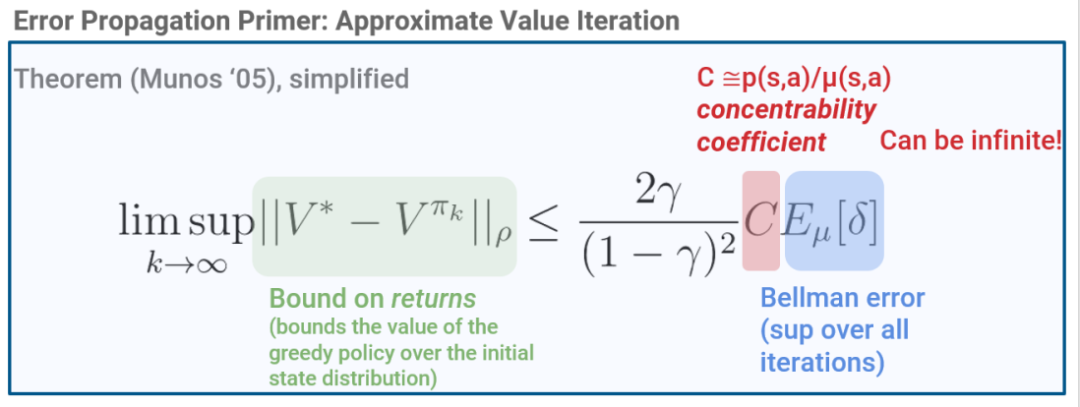
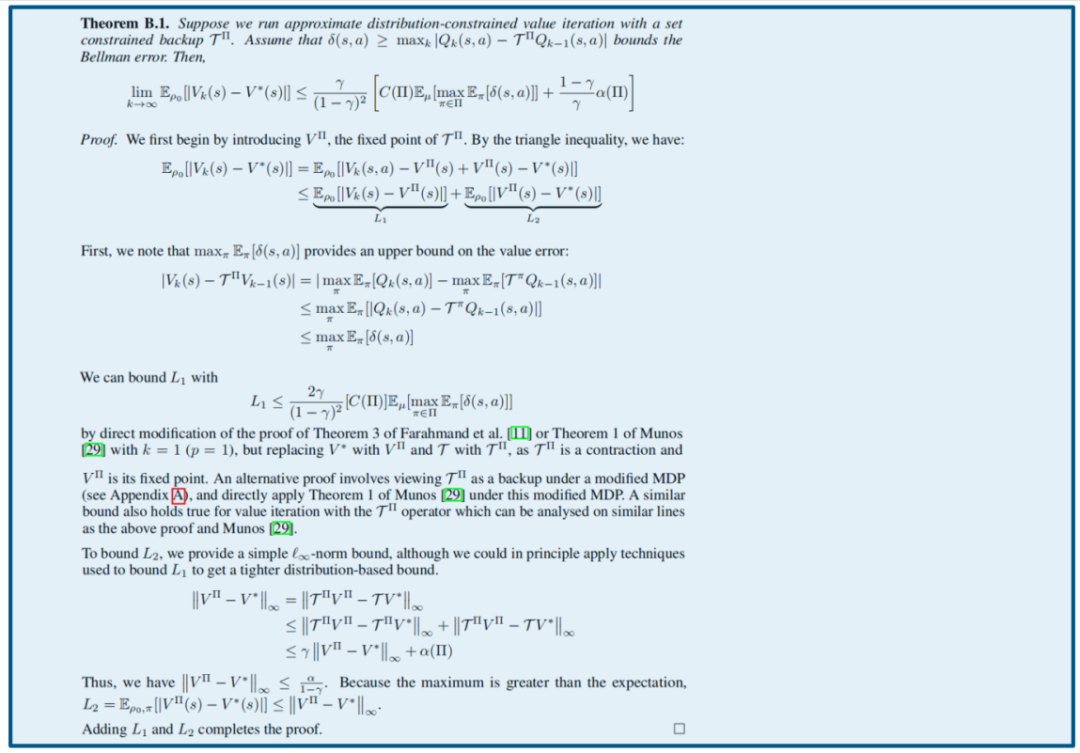
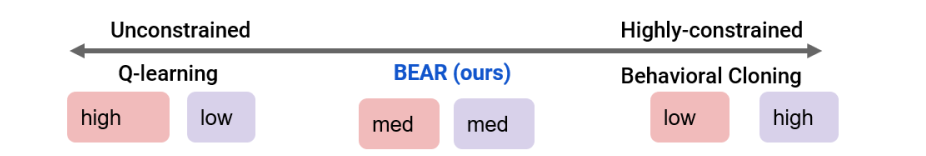
We change the policy improvement step, where instead of performing a maximization over all policies, we perform the restricted max over the set and in order to do this practically, we use a constrained formulation, where we use a constraint that performs support matching. We constrain the maximum mean discrepancy distance between the dataset and the actor to a maximal limit, using samples.
4.1.2 为什么要从 选取动作?
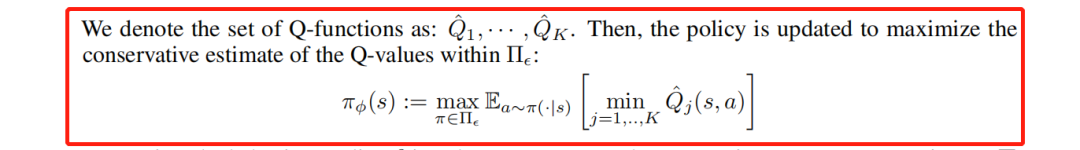
4.2 Maximum Mean Discrepancy (MMD)
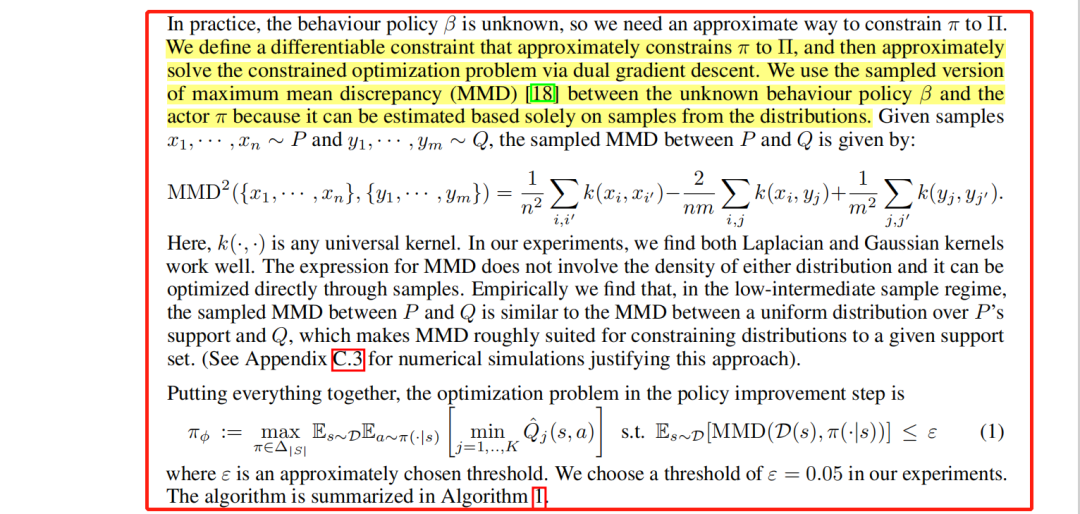
4.2.1 MMD原理
4.2.2 MMD代码求解
def gaussian_kernel(x, y, sigma=0.1):
  return exp(-(x - y).pow(2).sum() / (2 * sigma.pow(2)))

def compute_mmd(x, y):
  k_x_x = gaussian_kernel(x, x)
  k_x_y = gaussian_kernel(x, y)
  k_y_y = gaussian_kernel(y, y)
  return sqrt(k_x_x.mean() + k_y_y.mean() - 2*k_x_y.mean())
4.2.3 与KL divergence的区别
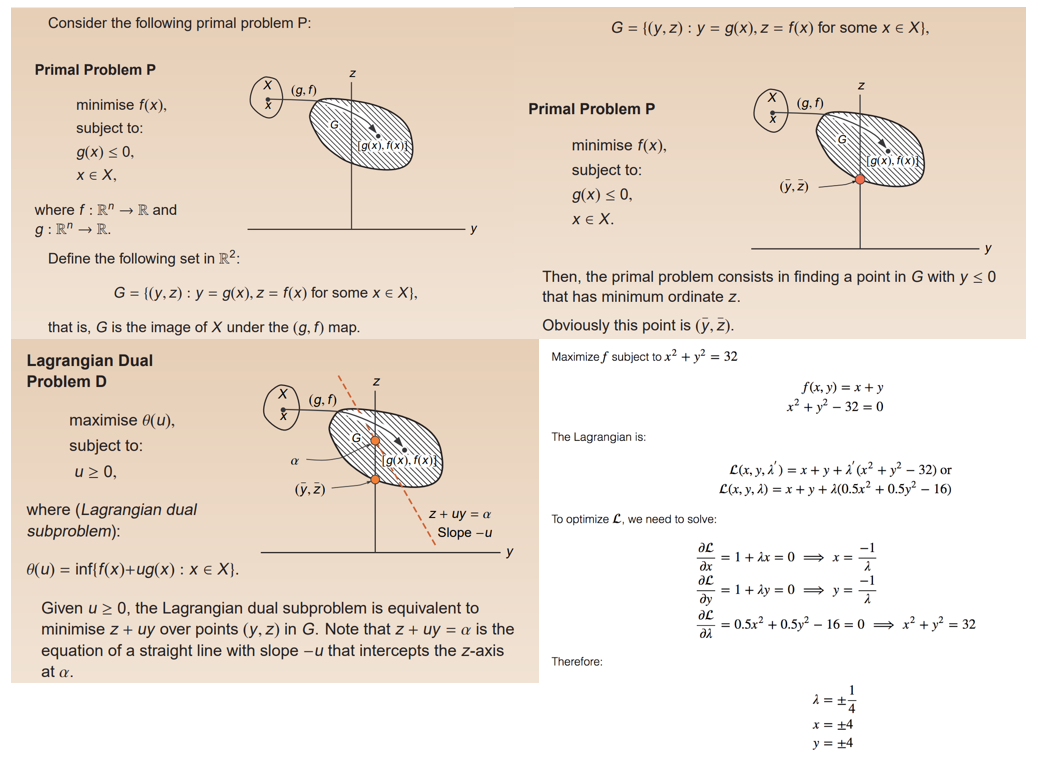
4.3 双梯度下降(Dual Gradient Descent)(可跳过)
4.3.1 DGD原理及图解[Dual Gradient Descent]
5. BEAR算法执行过程
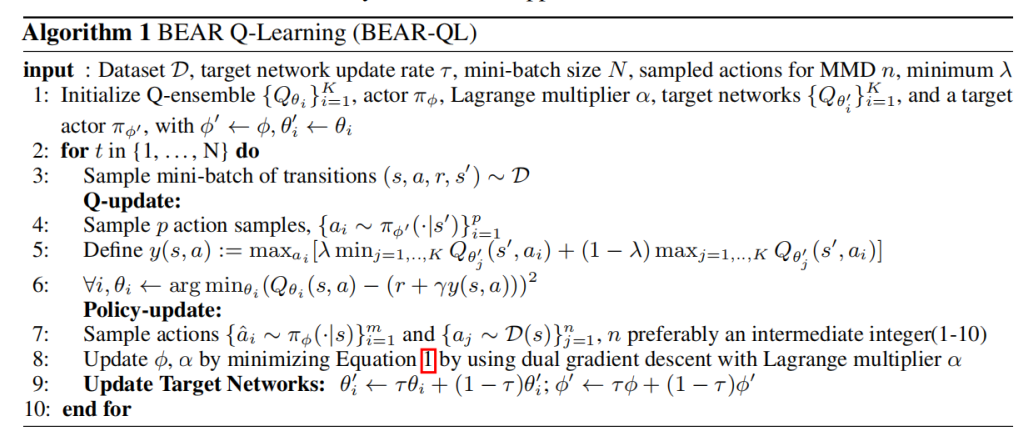
5.1 BEAR原版
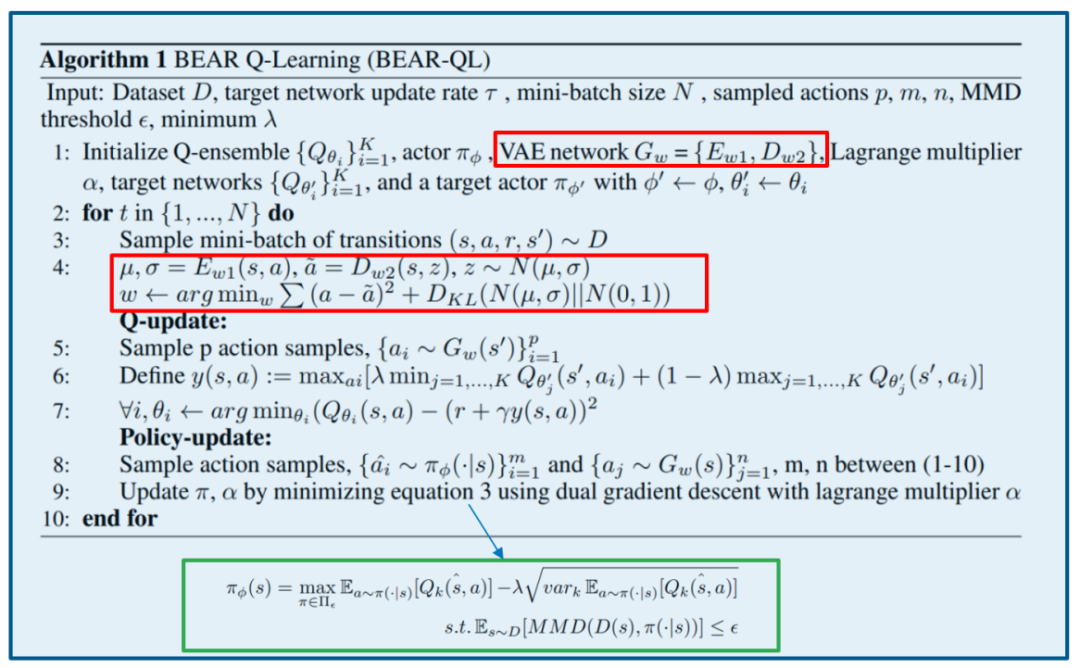
5.2 BEAR修补版
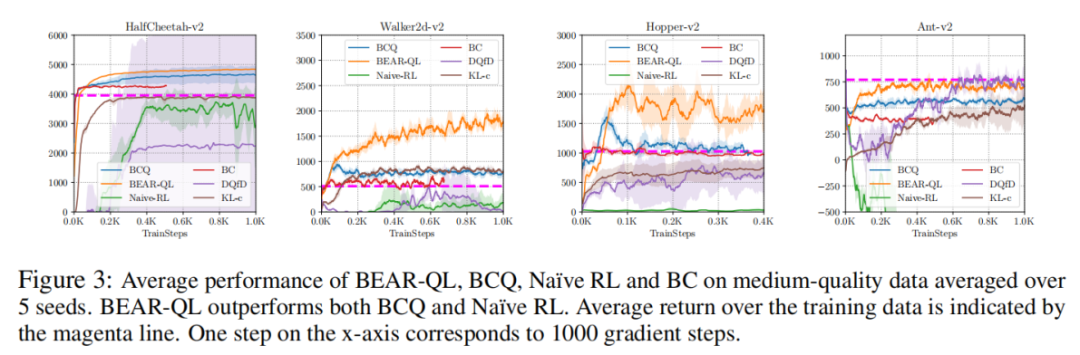
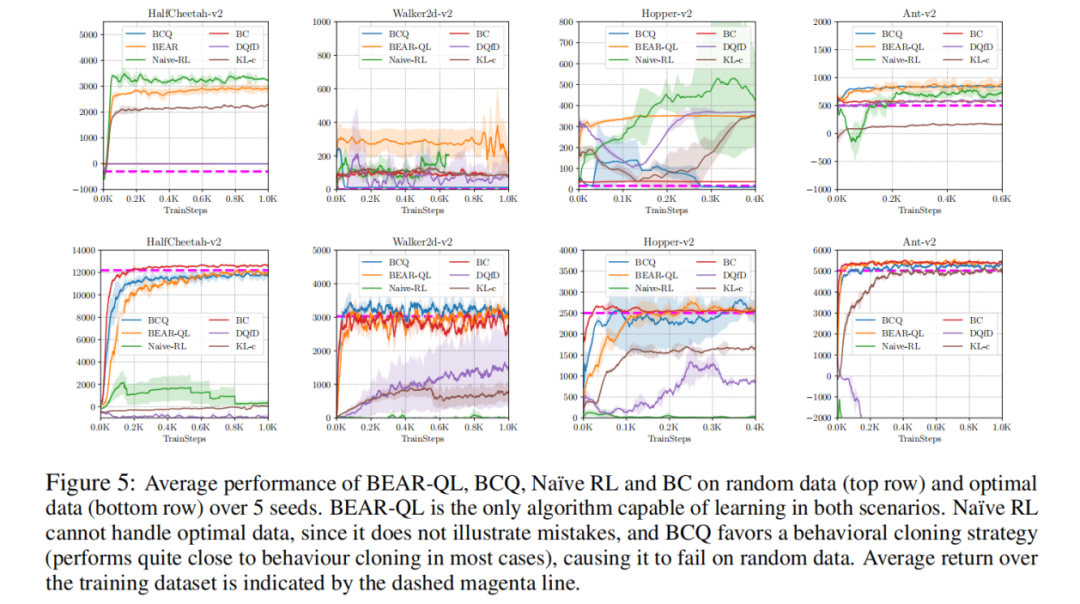
6. 部分结果分析
7. Pytorch代码实现部分浅析
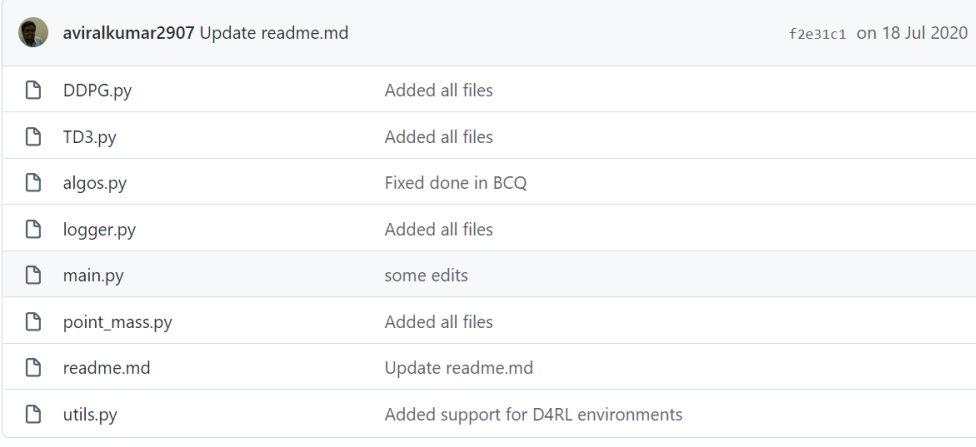
7.1 Installing & running
python main.py --buffer_name=buffer_walker_300_curr_action.pkl --eval_freq=1000 --algo_name=BEAR
--env_name=Walker2d-v2 --log_dir=data_walker_BEAR/ --lagrange_thresh=10.0
--distance_type=MMD --mode=auto --num_samples_match=5 --lamda=0.0 --version=0
--mmd_sigma=20.0 --kernel_type=gaussian --use_ensemble_variance="False"
分享
收藏
点赞
在看
评论