2022年5月下旬商汤CV实习面试题6道|含解析
公众号福利
👉回复【100题】领取《名企AI面试100题》PDF
👉回复【干货资料】领取NLP、CV、ML等AI方向干货资料
👉回复【往期招聘】查看往期重要招聘


问题1:说下RetinaNet的focal loss
RetinaNe论文引入Focal Loss是为了解决难易样本数量不平衡的问题,常见的交叉熵损失的公式如下:
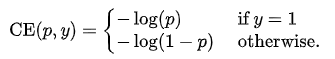
为了解决正负样本数量不平衡的问题,会在交叉熵损失前面加上一个参数,如下:
数学公式:
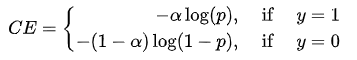
而Focal loss主要是为了解决难易样本不平衡的问题,因此会讲高置信度的样本(多数易分样本)的损失降低一些,就得到下下面的公式:
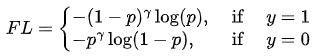
最终将正负不平衡和难易不平衡问题结合起来就得到下面的公式,也就是Focal Loss的最终形式:
问题2:什么是空洞卷积?计算空洞卷积的输出大小
空洞卷积也叫扩张卷积或者膨胀卷积,简单来说就是在卷积核元素之间加入一些空格(零)来扩大卷积核的过程。
计算过程:
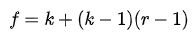
其中:k为原始卷积核大小,r为dia rate参数。
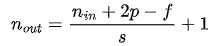
其中:n_in为输入的维度,n_out为输出的纬度,p为padding大小,f为卷积核大小,s为补长。
问题3:dice loss代码
keras代码实现:代码实现的时候,常会加上一个smooth,防止分母为0,由此公式可以变成:
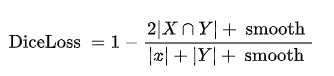
代码如下:
# 防止分母为0smooth = 100# 定义Dice系数def dice_coef(y_true, y_pred):y_truef = K.flatten(y_true) # 将y_true拉为一维y_predf = K.flatten(y_pred)intersection = K.sum(y_truef * y_predf)return (2 * intersection + smooth) / (K.sum(y_truef) + K.sum(y_predf) + smooth)# 定义Dice损失函数def dice_coef_loss(y_true, y_pred):return 1-dice_coef(y_true, y_pred)
问题4:计算IOU
IoU,即 intersection over Union,就是两个矩形框的交集面积与他们并集面积的比值。IoU也是一种算法性能的指标,例如在语义分割时就会用IoU来衡量分割效果的好坏。
x1,y1,x2,y2 = box1 #box1的左上角坐标、右下角坐标x3,y3,x4,y4 = box2 #box1的左上角坐标、右下角坐标#计算交集的坐标x_inter1 = max(x1,x3) #union的左上角xy_inter1 = max(y1,y3) #union的左上角yx_inter2 = min(x2,x4) #union的右下角xy_inter2 = min(y2,y4) #union的右下角y# 计算交集部分面积,因为图像是像素点,所以计算图像的长度需要加一# 比如有两个像素点(0,0)、(1,0),那么图像的长度是1-0+1=2,而不是1-0=1interArea = max(0,x_inter2-x_inter1+1)*max(0,y_inter2-y_inter1+1)# 分别计算两个box的面积area_box1 = (x2-x1+1)*(y2-y1+1)area_box2 = (x4-x3+1)*(y4-y3+1)#计算IOU,交集比并集,并集面积=两个矩形框面积和-交集面积iou = interArea/(area_box1+area_box2-interArea)
问题5:RetinaNet介绍以及创新点
RetinaNet:针对One-Stage算法的精度相对于Two_Stage偏低的问题,作者把这种问题的原因归结于正负类别不平衡(简单难分类别不平衡)。
创新点:
为了解决单阶段dense detect的正负样本不平衡的问题,提出了FocalLoss。
Focal Loss基于CrossEntropy Loss做了两处改进,使得能够很好地解决:正负样本数量不平衡、难易样本数量不平衡。
问题6:常用的目标检测网络介绍
主流目标检测框架可分成两类:①one-stage方法,以YOLO、SSD为代表;②two-stages方法,以RCNN系列为代表。前者检测速度快,但检测精度较低;后者检测速度慢,但是精度较高。
— 推荐阅读 —

最新大厂面试题
学员最新面经分享
七月内推岗位
AI开源项目论文
NLP ( 自然语言处理 )
CV(计算机视觉)
推荐